Goles esperados (xG) en fútbol y distribuciones de Poisson
El azar y la necesidad de ganar se mezclan en el fútbol cuando el resultado es lo único que importa. ¿Quién juega si no quiere ganar?
Goles esperados (xG) en fútbol y distribuciones de Poisson
El azar y la necesidad de ganar se mezclan en el fútbol cuando el resultado es lo único que importa. Después de todo… ¿quién juega si no quiere ganar? En tal caso, si “jugar bien” trajera suerte, bien vale estudiar cuánta de esa suerte podemos atraer llegando al arco rival.

Imagen ilustrativa de utilización de una matriz de resultados en un reporte.
Resultadistas
El análisis de rendimiento en el fútbol profesional requiere de herramientas matemáticas y estadísticas que permitan cuantificar la incertidumbre inherente al juego… aunque quizá todavía no lo sepamos.
Consientes o no de ello, sabemos que el uso de métricas avanzadas, como goles esperados, ofrece una alternativa para evaluar el desempeño de los equipos más allá de la varianza de un marcador. Pero esto no significa que dejemos el resultado de lado, de hecho, es en eso en lo que buscamos hacer hincapié
En este artículo se detalla la construcción y el funcionamiento de un modelo predictivo que simula los marcadores de un encuentro mediante el uso de distribuciones de Poisson, ofreciendo una perspectiva basada estrictamente en la probabilidad.
Fundamentos de la simulación
El núcleo de la propuesta se fundamenta en la premisa estadística de que los goles en un partido de fútbol pueden modelarse como eventos independientes que ocurren dentro de un marco temporal fijo de 90 minutos.
Para llevar a cabo esta aproximación, se emplea la distribución de Poisson, la cual permite calcular de manera precisa la probabilidad de que un equipo marque una cantidad específica de goles en función de su expectativa ofensiva. La relación matemática que rige el modelo se define de la siguiente manera:
P(x) = (e^(-λ) λ^x) / x!*
En esta ecuación, lambda representa la tasa de ocurrencia esperada, que en este contexto equivale al valor de los goles esperados del equipo, mientras que x es la cantidad discreta de goles que se desea simular. Al aplicar esta fórmula de manera separada para la fuerza de ataque del equipo local y del equipo visitante, se sientan las bases para recrear las condiciones de un partido completo.
Procesamiento de datos
A partir de estos principios teóricos, se desarrolla un motor de simulación automatizado. Para estabilizar la distribución de probabilidades y garantizar un volumen de muestra que reduzca el margen de error estadístico casi a cero, se ejecutan 100.000 iteraciones mediante métodos de simulación de Monte Carlo.
El proceso técnico se estructura en diversas etapas secuenciales. En la instancia inicial de ingesta, se extraen los datos desde archivos de formato separado por comas. Esta base de datos proporciona la información nominal de los equipos, los valores precisos de expectativa de gol y los códigos de color hexadecimales necesarios para la posterior renderización visual. Una vez cargados los datos, el algoritmo procesa las simulaciones iterativas, estableciendo un límite máximo teórico de goles posibles para mantener el modelo dentro de parámetros operativos realistas y evitar anomalías computacionales.
def simulate_match(home, away, home_xg, away_xg, max_goals=5, simulations=100000):

    home_mean_goals = home_xg
    away_mean_goals = away_xg

    results = []
for _ in range(simulations):
# Simular goles marcados por el equipo local y visitante en esta simulación
home_goals = np.random.poisson(home_mean_goals)
away_goals = np.random.poisson(away_mean_goals)
# Asegurarse de que los goles no excedan el máximo permitido
home_goals = min(home_goals, max_goals)
away_goals = min(away_goals, max_goals)
results.append((home_goals, away_goals))
# Convertir resultados a un DataFrame de pandas para análisis posterior
results_df = pd.DataFrame(results, columns=['home_goals', 'away_goals']) # Calcular la matriz de probabilidades de resultados esperados
max_possible_goals = max_goals
matrix = np.zeros((max_possible_goals + 1, max_possible_goals + 1))
for index, row in results_df.iterrows():
home_goals = row['home_goals']
away_goals = row['away_goals']
matrix[home_goals][away_goals] += 1
matrix /= simulations
# Crear un DataFrame de pandas para la matriz de probabilidades
df_simulation = pd.DataFrame(matrix, index=range(max_possible_goals + 1), columns=range(max_possible_goals + 1))
# Posibilidades de ganar de cada equipo
home_win = np.sum(np.tril(matrix, -1))
away_win = np.sum(np.triu(matrix, 1))
draw = np.sum(np.diag(matrix)) # Heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(df_simulation, annot=True, fmt=".3f", cmap="YlGnBu", cbar=True)
plt.title(f"Probabilidades de resultados para {home} vs {away}", fontsize=14)
plt.xlabel(away + " Goles", fontsize=12)
plt.ylabel(home + " Goles", fontsize=12)
plt.show() print(f'{home} tuvo {round(home_win*100,2)}% probabilidades de ganar.\n{away} tuvo {round(away_win*100,2)}% probabilidades de ganar.\nHubo {round(draw*100,2)}% de probabilidades de empate.')
returnMatrices de probabilidad
El resultado directo de esta simulación masiva es la generación de una matriz de probabilidad bivariada. Este componente cruza las variables independientes de los goles del equipo local con los goles del equipo visitante, asignando un porcentaje de ocurrencia a cada combinación exacta del marcador.
De este cálculo matricial se derivan métricas clave para el análisis del rendimiento. La suma de las probabilidades de los cuadrantes correspondientes permite extraer la probabilidad porcentual total de una victoria local, un empate o una victoria visitante.
Puntos esperados
Adicionalmente, se puede utilizar el modelo para calcular los puntos esperados (xPts) para cada equipo, ponderando la probabilidad de cada resultado por los puntos que otorga el reglamento en cada escenario.
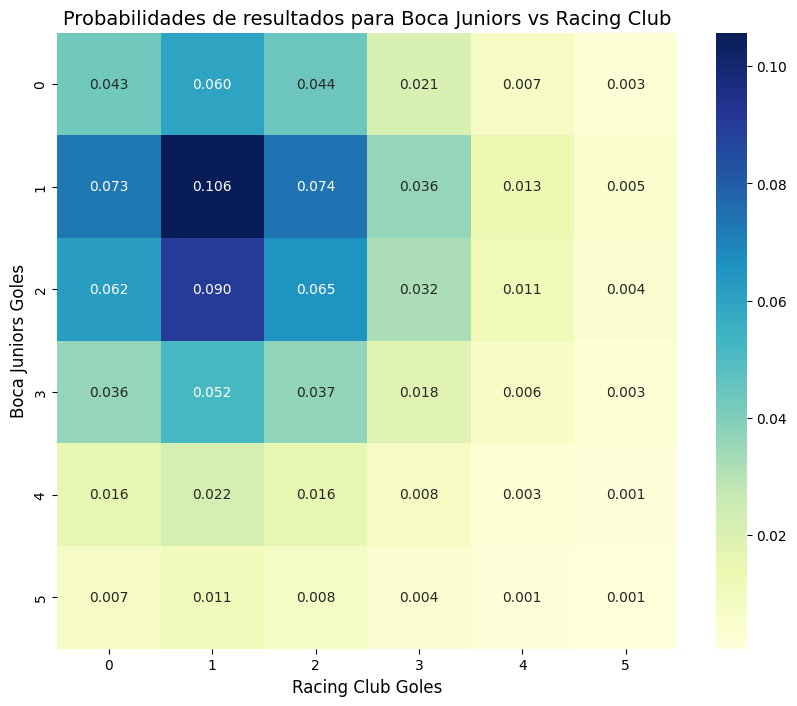
A modo de ejemplo, tomemos un procesamiento que arroja un 45% de probabilidad de triunfo para Boca Juniors, un 32% por ciento para Racing Club y un 24% de probabilidades de empate. A partir de eso transformamos las cifras en métricas de puntaje esperado. Boca obtiene 3.14 xPts y Racing 2.40 xPts.
from prettytable import PrettyTable
import time
df_xpts = pd.DataFrame(columns=['match_id', 'team', 'xPts'])
num_simulations = 50000
n=0for match_id in df_teams['match_id']: count_home_wins = 0
count_home_loss = 0
count_away_wins = 0
count_away_loss = 0
count_draws = 0
score_mat = []
tot_sim_time = 0 for i in range(num_simulations):
start_time = time.time() # Generar una distribución de Poisson aleatoria
target_home_goals_scored = np.random.poisson(home_xg)
target_away_goals_scored = np.random.poisson(away_xg)
home_win = 0
away_win = 0
draw = 0
margin = 0 # Si el equipo local convierte más goles, gana
if target_home_goals_scored > target_away_goals_scored:
count_home_wins += 1
count_away_loss += 1
home_win = 1
margin = target_home_goals_scored - target_away_goals_scored # Si el equipo visitante convierte más goles, gana
elif target_home_goals_scored < target_away_goals_scored:
count_away_wins += 1
count_home_loss += 1
away_win = 1
margin = target_away_goals_scored - target_home_goals_scored # Si ambos equipos convierten la misma cantdad de goles, hay empate
elif target_home_goals_scored == target_away_goals_scored:
draw = 1
count_draws += 1
margin = target_away_goals_scored - target_home_goals_scored # Se acrega el marcador
score_mat.append((target_home_goals_scored, target_away_goals_scored)) end_time = time.time()
tot_sim_time += round((end_time - start_time),5) home_win_probability = round((count_home_wins/num_simulations * 100),2)
away_win_probability = round((count_away_wins/num_simulations * 100),2)
draw_probability = round((count_draws/num_simulations * 100),2) sim_table_stats = PrettyTable(["Total # de sim", f"{home} gana", f"{away} gana", "Empates"])
sim_table_stats.add_row([num_simulations, count_home_wins, count_away_wins, count_draws])
sim_table_stats.add_row(["-", str(home_win_probability)+"%", str(away_win_probability)+"%", str(draw_probability)+"%"]) # Puntos esperados
home_xPts = (home_win_probability / 100) * 3.0 + (draw_probability / 100) * 1.0 + (away_win_probability / 100) * 0.0
away_xPts = (away_win_probability / 100) * 3.0 + (draw_probability / 100) * 1.0 + (home_win_probability / 100) * 0.0 lista = [match_id, home, home_xPts]
lista2 = [match_id, away, away_xPts]
df_xpts.loc[len(df_xpts)] = lista
df_xpts.loc[len(df_xpts)] = lista2 n+=1
print(match_id, n)Visualización
La lectura de datos crudos en formato tabular presenta desafíos cognitivos que dificultan la rápida asimilación de la información. Para resolver este obstáculo y facilitar la interpretación analítica, se implementa una solución visual basada en mapas de calor.
Mediante librerías de procesamiento de imágenes, se diseña un flujo de trabajo que toma la matriz matemática y le aplica escalas de color proporcionales a la densidad de la probabilidad. Cada equipo es representado por un color (al igual que en la cancha).
Posteriormente, la imagen generada se somete a un proceso de recorte y rotación a 45 grados. Esta transformación geométrica convierte la cuadrícula estándar en un formato de diamante, el cual optimiza la lectura al alinear el eje de empate en una diagonal central y separar claramente las zonas de victoria de cada conjunto a los lados. Es decir, tenemos dos equipos, uno arriba, otro abajo; en el medio, el empate.

Copa de la Liga Profesional 2024 Fecha 12 — Boca Juniors 2 v 1 San Lorenzo.
Interpretación de escenarios
La visualización final permite identificar de manera inmediata la naturaleza táctica y las expectativas del encuentro simulado, clasificando los partidos en diferentes tipologías visuales.
Cuando el mapa de calor revela una alta concentración de probabilidad en la coordenada inferior del 0–0, se diagnostica un escenario cerrado. Este patrón es característico de partidos donde ambos equipos presentan métricas de ataque muy bajas o esquemas fuertemente defensivos, sugiriendo un encuentro de fricción y escasez de oportunidades claras.

Copa de la Liga Profesional 2024 Fecha 12 — Talleres 1 v 0 Velez Sarsfield.
Por el contrario, cuando la matriz muestra una dispersión amplia hacia el centro del diamante y utiliza escalas de color combinadas, indica un partido abierto, dinámico y con intercambio de golpes. En estos casos, celdas como el 2–1 o el 2–2 concentran la mayor densidad, demostrando que ambos conjuntos poseen una expectativa de gol superior a la unidad y que la balanza puede inclinarse por detalles mínimos.

Copa de la Liga Profesional 2024 Fecha 11 — Argentinos Juniors 3 v 0 Rosario Central.
Finalmente, existe el escenario de asimetría o dominio absoluto. En estas visualizaciones, la coloración se agrupa de forma densa y exclusiva sobre uno de los ejes laterales. Resultados como un 3–0 o un 4–0 se presentan como las celdas más probables, evidenciando un partido donde un equipo monopoliza la expectativa ofensiva frente a un rival que estadísticamente carece de herramientas para vulnerar la portería contraria.
메타데이터
- post_id
- 3be67a437f9b
- slug
- goles-esperados-xg-en-fútbol-y-distribuciones-de-poisson-3be67a437f9b
- url
- https://medium.com/@agustingermanrojas/goles-esperados-xg-en-f%C3%BAtbol-y-distribuciones-de-poisson-3be67a437f9b
- canonical_url
- https://medium.com/@agustingermanrojas/goles-esperados-xg-en-f%C3%BAtbol-y-distribuciones-de-poisson-3be67a437f9b
- author_url
- https://medium.com/@agustingermanrojas
- status
- ok
- fetched_at
- 2026-08-30 13:07:21

