RAG (Retrieval-Augmented Generation): Yapay Zekanın Açık Kitap Sınavı
Büyük Dil Modellerinin (LLM) en büyük sorunu olan ‘halüsinasyon’u nasıl çözüyor? İşte detaylı rehber.
RAG (Retrieval-Augmented Generation): Yapay Zekanın Açık Kitap Sınavı
Büyük Dil Modellerinin (LLM) en büyük sorunu olan ‘halüsinasyon’u nasıl çözüyor? İşte detaylı rehber.

Üretken yapay zeka (Generative AI) dünyası son iki yıldır adeta bir volkan gibi patlıyor, özellikle Büyük Dil Modelleri (LLM — Large Language Model) ile birlikte inanılmaz bir hızla ilerliyor. ChatGPT, Gemini veya Llama gibi modeller; şiir yazabiliyor, kod üretebiliyor ve sorularımıza insana benzer yanıtlar verebiliyor. Peki ya bu yanıtlar bazen tamamen uydurma ise? Ya model, bilmediği bir soruya kendinden emin bir şekilde yanlış cevap verirse? İşte bu noktada karşımıza çıkan en büyük engel “halüsinasyon” (hallucination) sorunudur.
Evet, modeller kendinden emin bir şekilde tamamen uydurma bilgiler üretebiliyor. Hukuki bir dava özeti isterken, var olmayan bir emsal karar yaratabiliyor. Tıbbi bir soru sorduğunuzda, hiçbir bilimsel temeli olmayan bir ilacı önerebiliyor. Peki bu sorunu nasıl çözüyoruz?
İşte cevap: RAG (Retrieval-Augmented Generation).
Neyse ki bu sorunun oldukça etkili bir çözümü olan: Retrieval-Augmented Generation, yani kısaca RAG. Bu makalede, RAG’ın ne olduğunu, neden bu kadar önemli olduğunu, nasıl çalıştığını ve iş dünyasından araştırmaya kadar hangi alanlarda devrim yarattığını, sektör lideri şirketlerin bakış açılarıyla detaylandıracağız.
1. Giriş: LLM’lerin Ezberci Öğrenci Sorunu
Büyük dil modellerini, devasa bir kütüphanedeki binlerce kitabı ezberlemiş ama bu kitapların nerede olduğunu veya nasıl erişeceğini bilmeyen, son derece yetenekli bir ezberci öğrenci gibi düşünebilirsiniz. Bu öğrenci, ezberlediği bilgilerle harikalar yaratabilir, ancak ezberinin dışına çıktığında veya güncel bir bilgi istediğinizde sorun başlar. IBM Research’ün dil teknolojileri direktörü Luis Lastras’ın çok yerinde bir benzetmesiyle: “Modeli, gerçekleri kontrol etmeden önce cevabı ağzından kaçıran aşırı istekli bir stajyer çalışan olarak düşünün,”.
İşte bu noktada RAG, bu “aşırı istekli çalışana” bir kütüphaneci ve açık kitap imkanı sunuyor. RAG, modelin cevap vermeden önce güncel, doğrulanabilir ve özel bir bilgi kaynağına (bir kitap, şirket içi dokümanlar veya bir veri tabanı) “danışmasını” sağlıyor.

Bir yapay zeka modeli size bir bilgi veriyorsa, nereden bildiğini de gösterebilmeli. RAG işte bunu sağlar.
2. RAG Nedir? Açık Kitap Sınavının Gücü
Retrieval-Augmented Generation (RAG) veya Türkçesiyle Geri Çağırma-Artırılmış Üretim, büyük dil modellerinin (LLM) yanıtlarını, harici bir bilgi tabanından gerçek zamanlı olarak bilgi alarak (retrieval) ve bu bilgilerle zenginleştirerek (augmentation) daha doğru, güncel ve güvenilir hale getiren bir yapay zeka çerçevesidir.
Bu kavramı ilk kez 2020 yılında Patrick Lewis ve Facebook AI Research (şimdi Meta AI) ekibinin yayınladığı “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” başlıklı çalışma ile literatüre kazandırıldı. NVIDIA’nın da vurguladığı gibi, Patrick Lewis ekibi bu yöntemin bu kadar yaygınlaşacağını tahmin etseydi, isimlendirmeye daha fazla özen gösterirlerdi. Oracle’ın dediği gibi: “Basitçe söylemek gerekirse, RAG, LLM’lerin daha iyi yanıtlar vermesine yardımcı olur.”
Peki neden bu kadar önemli? Çünkü geleneksel LLM’ler, eğitildikleri verilerle sınırlıdır (kapalı kitap sınavı). Bu veriler aylar hatta yıllar öncesine ait olabilir. RAG ise modele, özel ve güncel bir bilgi havuzunda arama yapma izni verir (açık kitap sınavı). Bu sayede model, “Ben bilmiyorum” demeyi öğrenir ve cevaplarının kaynağını gösterebilir.

3. RAG Nasıl Çalışır? Adım Adım Mimari
RAG’ın çalışma prensibi, Microsoft Azure’un da detaylandırdığı gibi, iki ana modülün (alıcı ve üretici) kusursuz iş birliğine dayanır. Bu süreci iki ana aşamada inceleyebiliriz:

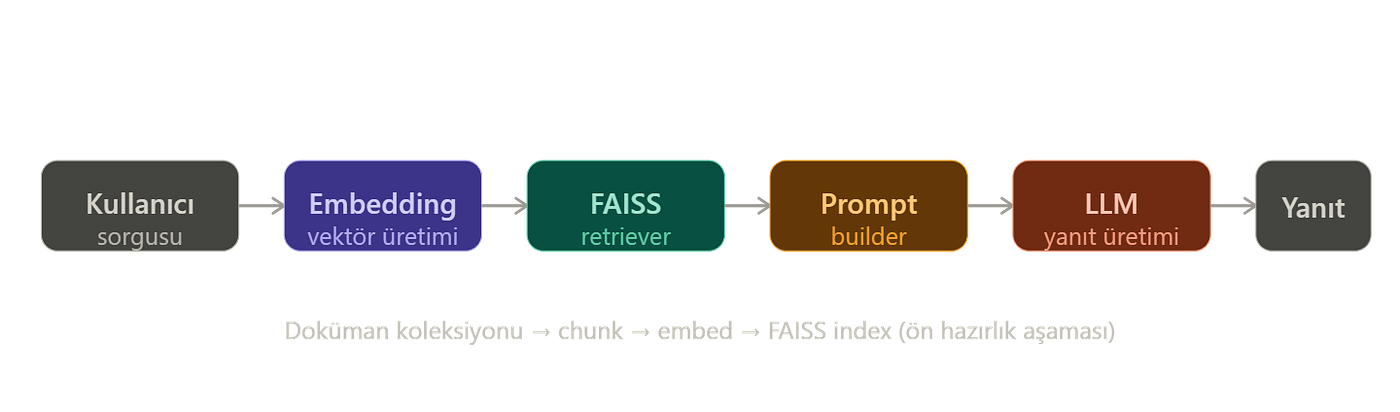
Aşama 1: Dizin Oluşturma (Indexing) — Bilgi Havuzunun Hazırlanması
Bu, RAG sisteminin “ders çalışma” aşamasıdır ve genellikle önceden yapılır.
- Veri Kaynağı: Şirket içi PDF’ler, web sayfaları, Notion dokümanları, SQL veritabanları gibi çeşitli kaynaklardan veri toplanır.
- Parçalama (Chunking): Toplanan bu dokümanlar, anlam bütünlüğünü bozmadan daha küçük, yönetilebilir parçalara (chunk) bölünür.
- Vektörleştirme (Embedding): Bu metin parçaları, bir gömme modeli (embedding model) kullanılarak sayısal temsillere, yani vektörlere dönüştürülür. Bu vektörler, metnin anlamsal olarak kodlanmış halidir.
- Vektör Veritabanında Saklama: Oluşturulan bu vektörler, hızlı benzerlik araması yapabilen özel bir veritabanında (Pinecone, Weaviate, Chroma, FAISS gibi) saklanır.
Aşama 2: Sorgulama ve Üretim (Inference) — Cevap Verme Anı
Bu, kullanıcı bir soru sorduğunda gerçekleşen gerçek zamanlı aşamadır.
- Kullanıcı Sorusu: Kullanıcı bir soru yazar. Örneğin: “Şirketimizin yeni izin politikasına göre yarım gün izin kullanabilir miyim?”
- Sorgunun Vektörleştirilmesi: Kullanıcının sorusu da aynı embedding modeli kullanılarak bir vektöre dönüştürülür.
- Bilgi Getirme (Retrieval): Bu sorgu vektörü, vektör veritabanında saklanan tüm vektörlerle karşılaştırılır. Amacımız, sorguya anlamca en yakın (en benzer) top-K doküman parçasını bulmaktır. Bu işlem genellikle kosinüs benzerliği (cosine similarity) ile yapılır.
- Bağlamın Zenginleştirilmesi (Augmentation): Bulunan en ilgili metin parçaları (örneğin, “Yarım Gün İzin Politikası” başlıklı bir dokümandan bir paragraf), kullanıcının orijinal sorusuna eklenir. Bu birleşim, zenginleştirilmiş bir “prompt” haline gelir.
- Cevap Üretimi (Generation): Bu zenginleştirilmiş prompt, LLM’e (GPT-4, Llama 3 gibi) gönderilir. Artık LLM, sadece kendi eğitim verilerine değil, önüne konulan bu somut ve güncel bilgi parçacıklarına dayanarak bir yanıt üretir.
- Kaynak Gösterimi (Citation): En iyi RAG sistemleri, ürettiği yanıtın hangi doküman parçasına dayandığını da kullanıcıya gösterir. Bu, güvenilirliği artıran en önemli özelliklerden biridir.
4. RAG Neden Bir Devrimdir? Geleneksel Yöntemlere Göre Avantajları
RAG’ı bu kadar popüler yapan, ona rakip yöntemlere (sıfırdan eğitme veya ince ayar) göre sağladığı ezici avantajlardır. DataCamp ve IBM’in vurguladığı gibi, RAG özellikle kurumsal dünyada birçok soruna çözüm getirir.

5. RAG’ın Zorlukları ve Sınırlamaları
Her ne kadar güçlü bir teknoloji olsa da, RAG’ın mükemmel olmadığını ve bazı zorlukları beraberinde getirdiğini de belirtmek gerekir. Oracle’ın da işaret ettiği gibi, bu zorluklar aktif bir araştırma alanıdır.
- Düşük Kaliteli Bilgi Getirme: En kritik aşama, doğru dokümanları bulmaktır. Eğer veriler kötü parçalanmışsa (chunking), embedding modeli yetersizse veya vektör veritabanı doğru kurulmamışsa, LLM’e alakasız bilgiler gönderilir ve bu da kötü cevaplara yol açar. (“Çöp giren, çöp çıkar”).
- Bağlam Penceresi Sınırı: LLM’lerin bir seferde işleyebileceği metin miktarı sınırlıdır (bağlam penceresi). Çok fazla doküman parçası getirmek, bu pencereyi aşabilir veya maliyeti artırabilir.
- Gecikme (Latency): İki aşamalı bir süreçtir (önce getirme, sonra üretme). Bu, tek bir LLM çağrısına göre daha yavaştır. Gerçek zamanlı uygulamalar için optimizasyon şarttır.
- Karmaşık Sorgular: “İstanbul’daki deprem riski yüksek olan ve fiyatı 1 milyon TL altında olan mahalleler hangileridir?” gibi çok aşamalı veya mantıksal akıl yürütme gerektiren sorular, basit bir RAG için zordur. Burada daha gelişmiş “Agentic RAG” devreye girer.
6. RAG Nerelerde Kullanılır? Sektörler ve Örnekler
RAG’ın esnekliği, onu hemen hemen her sektörde kullanılabilir kılar. IBM, Azure ve Oracle kaynaklarından derlediğimiz bazı çarpıcı örnekler:
- Müşteri Desteği ve Chatbot’lar: Bir ürünün kullanım kılavuzuna, garanti şartlarına veya SSS’lerine dayanarak soruları yanıtlayan, bağlamsal olarak doğru ve son derece sabırlı bir müşteri temsilcisi.
- Kurum İçi Bilgi Yönetimi (HR & IT): “Yeni ebeveynlik izni politikası nedir?” sorusuna, güncel İK dokümanlarını ve çalışanın kendi izin durumunu (veritabanından) referans göstererek kişiselleştirilmiş bir cevap üreten bir asistan.
- Hukuk: Avukatların, binlerce sayfalık dava dosyası, emsal karar ve kanun maddesi içinde anında arama yaparak içtihatları bulması ve özetlemesi.
- Sağlık: Doktorların, bir hastanın semptomlarını ve geçmişini alarak en güncel tıbbi araştırmalar ve ilaç prospektüslerinden bilgiler sunan bir tanı destek sistemi.
- Finans ve Yatırım: Bir yatırım bankasının, son çeyrek raporları, piyasa haber akışları ve makroekonomik verileri kullanarak bir şirket hakkında yatırım raporu hazırlaması.
- Eğitim: Öğrencilerin, sadece ders kitabındaki bilgilere dayanarak sorular sorduğu ve cevapların kaynağını gösterdiği bir “açık kitap” öğrenme asistanı.
7. RAG’ın Geleceği: Agentic RAG ve Çok Modlu Dünya
RAG teknolojisi durmuyor. Gelecekte bizi neler bekliyor? İşte öne çıkan trendler:
- Agentic RAG (Etmen Tabanlı RAG): RAG, pasif bir “getir-üret” döngüsünden çıkıp, karmaşık görevleri otonom olarak planlayabilen ve birden fazla aracı (hesap makinesi, API, veritabanı) kullanabilen yapay zeka ajanlarına dönüşüyor. Örneğin, “En iyi uçuş fiyatını bul ve takvimime ekle” dediğinizde, ajan önce hava durumunu, sonra uçuş fiyatlarını, sonra takviminizi getirir (RAG) ve ardından bir API çağrısı ile takviminize ekler.
- Multimodal RAG: Sadece metin değil, görseller, videolar, ses dosyaları ve diğer veri türlerini de anlayıp getiren RAG sistemleri. Örneğin, bir makinenin bakım kılavuzundaki bir şemayı veya bir ürünün fotoğrafındaki kusuru tespit edip ilgili metni getirebilmek.
- Sürekli Öğrenen (Adaptive) RAG: Kullanıcı geri bildirimlerine göre kendini sürekli güncelleyen, hangi getirme stratejisinin daha iyi olduğunu öğrenen dinamik RAG sistemleri.
Sonuç: RAG ile Güvenilir Yapay Zekaya Doğru
RAG, üretken yapay zekanın önündeki en büyük engellerden olan güvenilirlik, güncellik ve şeffaflık sorunlarına karşı geliştirilmiş en pratik ve etkili çözümdür. LLM’lerin yaratıcı gücünü, kurumsal hafızanın somut gerçekleriyle buluşturarak yapay zekanın sadece “konuşan” değil, aynı zamanda “doğrulayan” ve “kanıt gösteren” bir teknoloji haline gelmesini sağlar.
Bir sonraki projenizde, bir sohbet robotu veya bilgi sistemi geliştiriyorsanız, modeli yeniden eğitmek için kaynak harcamadan önce bir RAG mimarisi kurmayı deneyin. Vektör veritabanları ve LangChain / LlamaIndex gibi araçlar sayesinde, temel bir RAG sistemi sadece birkaç satır kodla hayata geçirilebilir.
Unutmayın, yapay zekanın geleceği, sadece daha büyük modellerde değil, daha iyi bilgiye erişebilen modellerde gizlidir. Ve bu erişimi sağlayan anahtar teknolojinin adı: RAG.
Retrieval-Augmented Generation Hakkında Sık Sorulan Sorular
RAG, üretken yapay zeka ile aynı şey mi?
Hayır. RAG, LLM’de yer almayan bilgileri de kullanabildiği için, alma ile artırılmış oluşturma, sorgulara genel bir büyük dil modelinin kendi başına sağlayabileceğinden daha doğru sonuçlar sağlayabilen bir tekniktir.
RAG’de ne tür bilgiler kullanılır?
RAG; ilişkisel veritabanları, yapılandırılmamış doküman havuzları, internet veri akışları, medya haber akışları, ses transkripsiyonları ve işlem günlükleri gibi birçok kaynaktan gelen verileri içerebilir.
Üretken yapay zeka RAG’yi nasıl kullanır?
Kurumsal veri kaynaklarından gelen veriler bilgi havuzunda gömülü hale getirilir ve vektör veritabanında depolanan vektörlere dönüştürülür. Son kullanıcı bir sorgu yaptığında, vektör veritabanı bağlama dayalı ilgili bilgileri alır. Bağlama dayalı bu bilgiler, sorgu ile birlikte daha güncel, doğru ve bağlama dayalı bir yanıt oluşturmak için bağlamı kullanan büyük dil modeline gönderilir.
RAG, aldığı veriler için referansları belirtebilir mi?
Evet. RAG tarafından kullanılan vektör veritabanları ve bilgi veri havuzları, bilgi kaynakları hakkında belirli bilgiler içerir. Bu sayede kaynaklar belirtilebilir ve bu kaynaklardan birinde hata varsa, sonraki sorguların bu yanlış bilgileri döndürmemesi için kaynaklar hızla düzeltilebilir veya silinebilir.
Bu sistemin temel bileşenleri nelerdir? Nasıl çalışırlar?
Bu sistemin iki temel bileşeni vardır: bilgi toplayıcı ve bilgi oluşturucu . Bilgi toplayıcı, belgeler, web siteleri veya veritabanları gibi harici kaynaklardan ilgili bilgileri araştırır ve toplar. Bilgi oluşturucu ise bu bilgileri kullanarak doğru ve anlaşılır metinler üreten gelişmiş bir dil modelidir.
Bu sistem mevcut makine öğrenimi işlem hatlarıyla nasıl entegre olur?
Geliştiriciler, RAG’ı doğal dil işleme (NLP) görevlerinin yönetimi için önemli bir bileşen olarak kullanarak mevcut makine öğrenimi (ML) işlem hatlarına entegre ederler. Bu sistemin bilgi alma bileşeni, girdi sorgusuna göre ilgili bilgileri aradığı bir belge kümesine veya veritabanına bağlıdır.
Üretken model daha sonra çıkarılan bilgileri işleyerek bir yanıt oluşturur. Bu benzersiz entegrasyon, RAG’ın mevcut veri altyapısını ve kaynaklarını farklı makine öğrenimi sistemlerine ve süreçlerine kolayca entegre etmek için kullanmasına olanak tanır.
Soruları yanıtlamak ve özetlemek için bir RAG sistemi nasıl oluşturulur?
Soru cevaplama sistemi oluşturmak için, bir belge bulucu ve bir ince ayar oluşturucu olmak üzere iki bileşen seçmemiz gerekiyor. Belge bulucu, kullanıcının sorgusuna uygun belgeleri verimli bir şekilde bulacak ve getirecektir. Anahtar kelime aramaları gibi geleneksel bir yaklaşım kullanabileceği gibi, yoğun gömme gibi daha gelişmiş teknikler de kullanabilir. İnce ayar oluşturucu ise aynı belgeyi kullanarak tutarlı ve doğru cevaplar üretecektir.
Özetleme sistemi oluşturmak için, ilgili konuyla alakalı içeriği toplayacak bir veri toplayıcıya ihtiyaç duyulur. Ardından, bu içerik, özlü ve anlamlı özetlere dönüştürülür. Burada ayrıca, daha alakalı ve doğru yanıtlar verebilmek için istem mühendisliği de çok önemli bir rol oynar.
Vektör Veritabanı nedir ve RAG için neden önemlidir?
Vektör veritabanı, vektör gömülü temsillerini verimli bir şekilde depolamak ve aramak için tasarlanmış özel bir veritabanıdır. Gömülü temsiller, metin, görüntü veya diğer veri türlerinin anlamsal anlamlarını yakalayan sayısal gösterimleridir. Bir RAG sisteminde, belgeler bir gömülü temsil modeli kullanılarak gömülü temsillere dönüştürülür ve bir vektör veritabanında saklanır.
Kullanıcı bir sorgu gönderdiğinde, sorgu aynı zamanda bir gömme vektörüne dönüştürülür. Vektör veritabanı daha sonra, gömme vektörleri sorgu gömme vektörüne en yakın olan belgeleri bulmak için bir benzerlik araması gerçekleştirir. Elde edilen bu belgeler, doğru yanıtlar üretmek için büyük dil modeline bağlam olarak sağlanır.
RAG sistemlerinde kullanılan popüler vektör veritabanları arasında Pinecone, Weaviate, Milvus, Chroma ve FAISS yer almaktadır. Bu araçlar, ilgili bilgilere hızlı bir şekilde ulaşmaya yardımcı olarak, modern bilgi edinme destekli üretim sistemlerinin vazgeçilmez bir bileşenini oluşturmaktadır.
RAG herhangi bir LLM ile entegre edilebilir mi?
Evet, RAG, OpenAI’nin GPT modelleri, BERT tabanlı modeller ve diğer transformatör mimarileri de dahil olmak üzere çeşitli dil modelleriyle uygulanabilir.
RAG gerçek zamanlı uygulamalar için kullanılabilir mi?
Evet, RAG müşteri hizmetleri sohbet botları ve yapay zeka asistanları gibi gerçek zamanlı uygulamalarda kullanılabilir, ancak performans verimli veri alma ve yanıt oluşturmaya bağlıdır.
RAG, veri alma işlemi için belirli bir veritabanı türü gerektiriyor mu?
Hayır, RAG, SQL veritabanları, NoSQL veritabanları ve FAISS ve Milvus gibi vektör veritabanları da dahil olmak üzere çeşitli veri depolama çözümleriyle çalışabilir.
Bonus:
Kaynakları Güncel Tutmak
Arka planda, gömme modeli, yeni ve güncellenmiş bilgi tabanları kullanıma sunulduğunda, makine tarafından okunabilir indeksler (bazen vektör veritabanları olarak da adlandırılır) sürekli olarak oluşturur ve günceller.

Birçok geliştirici, açık kaynaklı bir kütüphane olan LangChain’i, özellikle LLM’leri, gömme modellerini ve bilgi tabanlarını birbirine bağlamada oldukça kullanışlı bulmaktadır. NVIDIA, geri alma destekli üretim için referans mimarisinde LangChain’i kullanmaktadır.
LangChain topluluğu, RAG süreci için kendi tanımını sunmaktadır .
Üretken yapay zekanın geleceği, otonom asistanlar oluşturmak için dilsel öğrenme modellerinin ve bilgi tabanlarının dinamik olarak düzenlendiği ajansal yapay zekada yatmaktadır . Bu yapay zeka destekli ajanlar, karar verme süreçlerini iyileştirebilir, karmaşık görevlere uyum sağlayabilir ve kullanıcılara yetkili, doğrulanabilir sonuçlar sunabilir.
Bu yazı serisi kendime çevrimiçi bir not defteri ve bu yazı da onlarca notumun ilki..
Daha detaylı bir RAG anlatımı için bu kaynağı ziyaret edebilirsiniz.: https://mallahyari.github.io/rag-ebook/
메타데이터
- post_id
- 5639c20d5741
- slug
- rag-retrieval-augmented-generation-yapay-zekanın-açık-kitap-sınavı-5639c20d5741
- url
- https://medium.com/@gulezgin/rag-retrieval-augmented-generation-yapay-zekan%C4%B1n-a%C3%A7%C4%B1k-kitap-s%C4%B1nav%C4%B1-5639c20d5741
- canonical_url
- https://medium.com/@gulezgin/rag-retrieval-augmented-generation-yapay-zekan%C4%B1n-a%C3%A7%C4%B1k-kitap-s%C4%B1nav%C4%B1-5639c20d5741
- author_url
- https://medium.com/@gulezgin
- status
- ok
- fetched_at
- 2026-06-21 07:44:09