HIPPO는 Vision Pro에서 3D내시경 영상을 어떻게 출력하나요?
*이해를 위해 구조를 단순화한 설명입니다. 여기서는 핵심 흐름만 다루었기 때문에. 실제구현 시 추가 고려 사항이 존재합니다.
HIPPO는 Vision Pro에서 3D내시경 영상을 어떻게 출력하나요?
*이해를 위해 구조를 단순화한 설명입니다. 여기서는 핵심 흐름만 다루었기 때문에. 실제구현 시 추가 고려 사항이 존재합니다.
기본적으로 visionOS의 3D 영상은 MPEG4 및 QuickTime에서 지원하는 Multiview - High Efficiency Video Encoding(MV-HEVC) 형식을 사용합니다. HIPPO 또한 이 방식을 이용합니다. 다음의 파이프라인은 다양한 포맷으로 출력될 수 있는 내시경 영상을 비전프로에서 MV-HEVC로 변환할 수 있도록 하기 위해 구성되었습니다.
HIPPO의 내시경 영상 송출 파이프라인의 물리적 연결은 다음과 같습니다.
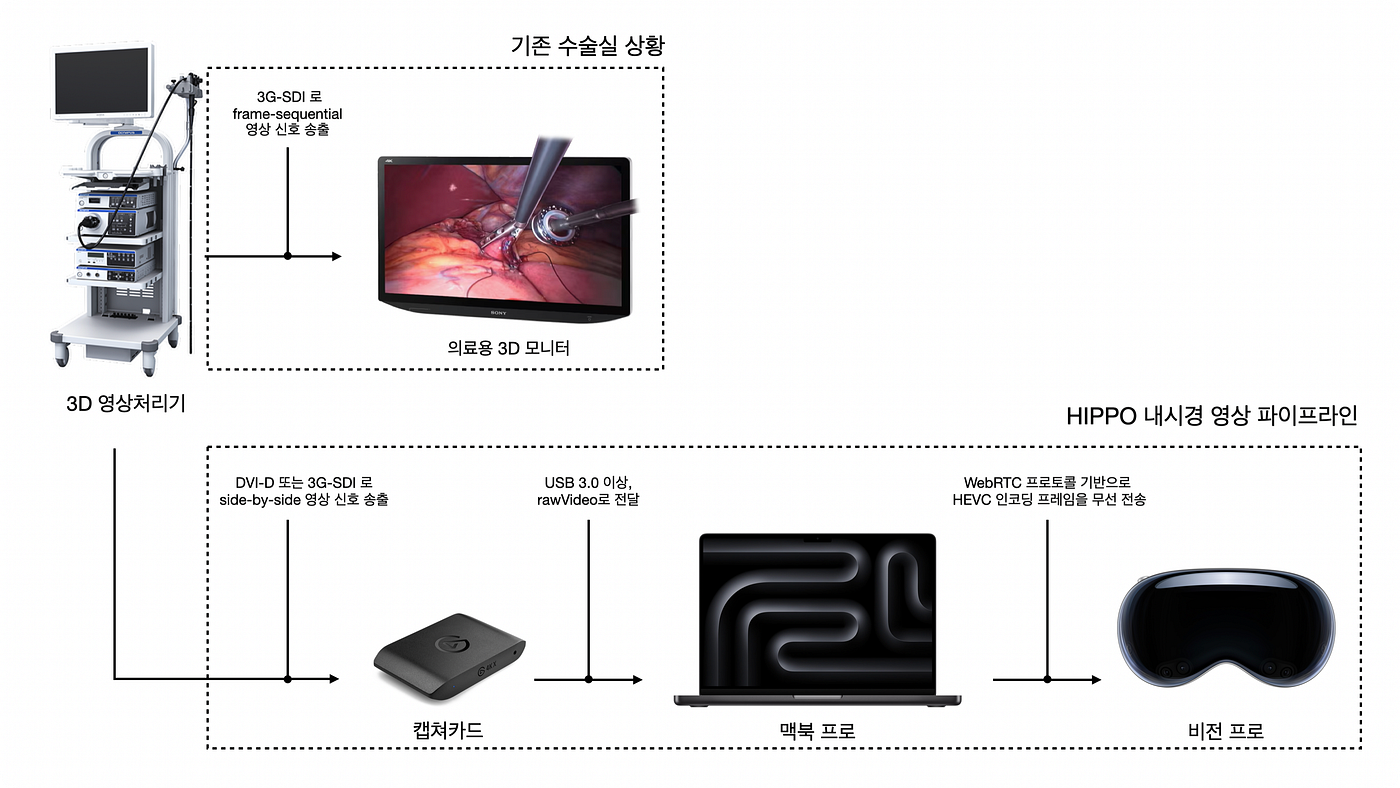
영상 데이터 처리과정의 큰 흐름은 다음과 같습니다.

1. 내시경 영상 캡쳐

3D 내시경 기기는 단안 영상처리기 2개와 양안 영상처리기 1개, 그리고 광원장치로 이루어져 있습니다.
HIPPO의 스트리밍 파이프라인은 3D 영상처리기로부터 Side-by-Side(SBS) 형태의 스테레오 영상을 인풋으로 받는 것으 가정하고 설계되었습니다. 따라서 3D영상처리기가 SBS출력을 지원하는 경우, 그대로 받아 사용할 수 있습니다.

side-by-side 영상의 좌우 프레임은 겉보기엔 같은 장면을 두 번 배치한 것처럼 보입니다. 하지만, 자세히 보면 두 영상이 미묘하게 다릅니다.
하지만 3D 내시경 영상처리기 중에는 SBS대신 frame-sequential 방식의 출력만 지원하는 경우가 있습니다.


frame-sequential 방식은 side-by-side방식과 다르게 한 번에 하나의 프레임만 보여줍니다. 두 프레임이 빠르게 번갈아 나타나기 때문에 실제로는 두 장면이 겹쳐서 보입니다.

이런 경우에는 3D 영상처리기와 연결된 단안 영상처리기로부터 각각의 단안 영상들을 받아 SBS로 합성하는 방식으로 처리합니다.
2. SBS 합성(옵션)
SBS 합성 시, 가장 중요한 부분은 서로 다른 인풋으로 들어온 영상 프레임의 시간 간격을 맞추는 것입니다. 왜냐하면 두 인풋의 프레임이 항상 같은 시점의 것이라고 단정할 수 없기 때문입니다. 그래서 HIPPO는 절대 PTS를 기준으로 두 프레임 간격이 일정 시간 오차 이내라면 같은 시점의 프레임으로 간주하고 짝을 지은 후 하나의 SBS프레임으로 합성합니다. 이 때 합성된 프레임의 시점은 좌우 프레임 타임스탬프의 평균값을 따라갑니다.

한 쌍의 프레임을 구했다면 두 프레임 픽셀버퍼의 크기(해상도)를 계산한 후, 새로운 픽셀버퍼로 복사 배치합니다.

3. HEVC 인코딩
앞서 캡쳐한 영상은 무손실 영상입니다. 그렇다는 것은 영상의 데이터가 크다는 뜻이며, 이는 비전프로로 영상을 전송하기에는 부담스러울 수 있다는 뜻입니다. 그래서 영상 데이터를 압축해야 합니다. HEVC는 압축 효율이 높은 코덱입니다. 영상을 전송하기에 적합한 포맷이므로 인코딩을 진행합니다.
인코딩은 Apple에서 제공하는 프레임워크인 VideoToolBox의 VTCompressionSession을 이용합니다.

실제 인코딩은 VTCompressionSessionEncodeFrame이라는 매서드를 이용합니다. 이 때, 다음과 같은 정보들을 요구합니다.
- 인코더 설정(VTCompressionSessionCreate로 만든 인코더 인스턴스)
- 인코딩할 입력 영상의 프레임
- 프레임의 타임스탬프
- 프레임의 지속시간
- 해당 프레임에만 적용되는 추가 설정
- …
그리고 인코더 설정을 생성하기 위해서 VTCompressionSessionCreate라는 메서드를 이용합니다. 여기서는 “어떤 코덱으로 어떤 크기의 프레임을 넣을 것이며, 결과는 어디서 받을지”에 관한 부분들이 설정 되어야 합니다. 구체적으로는 다음과 같은 정보들이 필요합니다.
- 압축 프로세스를 할당할 메모리
- 압축할 영상의 해상도
- 어떤 코덱으로 압축할 것인지
- 압축 시 추가 설정 사항(옵션)
- 압축에 투입할 영상의 특성(ex. 색영역, 해상도 등)
- 압축한 영상 프레임 데이터를 저장할 메모리
- 압축 결과가 나올 때마다 호출되는 콜백 함수 포인터
인코딩된 프레임은 CMSamplebuffer의 형태로 VTCompressionOutputCallback을 통해 접근 가능합니다.
4. 패킷화
영상데이터를 전송하기 위해서는 영상의 각 프레임을 바이트로 변환하여야 합니다. 인코딩된 프레임은 CMSampleBuffer의 형태로 존재합니다. 이 CMSampleBuffer를 그대로 비전프로로 전송할 수 있다면 좋겠지만, 안타깝게도 CMSampleBuffer를 타입 그대로 전송할 수 없습니다.
전송을 위해서는 패킷화 과정이 필요합니다.
- HEVC 프레임을 NAL 단위로 분리
- 패킷 구성(RTP)
NAL은 HEVC 프레임을 구성하는 기본 단위입니다. 각 프레임의 정보를 담고 있는 NAL Unit을 I-frame NAL, P/B frame NAL이라고 합니다. 하지만 이것만으로는 해당 NAL이 HEVC인지 알 수 없습니다. 왜냐하면, 다른 영상 코덱, 이를테면 H.264도 NAL Unit을 사용하기 때문입니다. 그래서 헤더코드를 통해 이를 구분합니다. 헤더 코드에서 32, 33, 34라는 값을 사용하는 NAL을 각각 VPS, SPS, PPS라고 하며, HEVC임을 구분하기 위한 중요한 단서가 됩니다.

*부가설명
혹시, NAL 타입 값은 32, 33, 34인데 예시를 보면 헤더코드가 왜 40 01, 42 01, 44 01로 표시되어 있는지 궁금하지 않으신가요? (궁금하지 않으시다면 이 부분은 넘어가 주세요.)

그 이유는 NAL의 헤더 코드는 NAL 타입에 관한 정보 뿐만 아니라 layer_id(계층 id), temporal_id(시간)에 관한 정보까지 함께 담아서 표현하기 때문입니다. 그래서 헤더코드만 분리해서 2진수로 변환하면
01000000000000001
이 되며, 이를 정보 단위로 분해하면
0 100000 000000 001
이 됩니다. 이 때 두 번째 덩어리 값이 NAL 타입에 관한 정보가 됩니다.
이진수 100000 이니 십진수로 변환하면 32가 됩니다. 즉, 앞서 언급한 VPS에 해당하는 NAL임을 알 수 있게 되는 것입니다. 하지만 표현은 바이트 단위로 끊기 때문에
01000000 00000001
이 되며, 16진수로 변환하면 40 01이 됩니다.
이렇게 HEVC 프레임을 NAL 단위로 분리했다면 이제는 여기에 실시간 송수신을 위한 데이터를 덧붙여야 합니다. 이 작업에 RTP 프로토콜이 사용됩니다. HIPPO에서는 RTP 패킷을 WebRTC 스택이 내부적으로 처리합니다.
여담으로, RTP 패킷은 12바이트로 구성되며, 패킷 순서 복원 정보, 어떤 송신자로부터 온 스트림인지 구분하기 위한 정보, 타임스탬프, 미디어 타입, 프레임 경계 등의 정보가 담깁니다. 이 때 기존의 시작 코드(00 00 00 01)는 제거합니다.

이제 영상 데이터 전송을 위한 준비과정을 모두 마쳤습니다.
5. 송수신 연결 및 전송
LiveKitWebRTC 스택 내부에서 시그널링 및 전송이 진행됩니다.
6. 패킷복원
LiveKitWebRTC 스택 내부에서 데이터를 수신합니다.
수신한 패킷을 CMSampleBuffer로 재조립하는 과정을 거칩니다.
7. HEVC 디코딩
인코딩을 VTCompressionSession을 이용하였듯, 디코딩은 VTDecompressionSessionDecodeFrame을 이용하여 진행됩니다.

요구하는 정보는 다음과 같습니다.
- 디코더 설정(어떤 해상도, 어떤 코덱, 어떤 설정인지)
- 디코딩할 CMSampleBuffer(여기에 프레임의 비트스트림과 타임스탬프, 그리고 포맷정보가 포함되어 있습니다.)
- 디코딩 옵션 플래그(어떻게 디코딩 할지 ex. 프레임 드랍 정책, 출력 프레임 생성 여부)
- 디코딩 콜백 컨텍스트 포인터:
- 디코드 결과 상태(디코드를 어떻게 처리했는지)
VTCompressionSession과 마찬가지로 디코더 설정이 필요합니다. VTDecompressionSessionCreate라는 메서드를 사용합니다. 이 역시 “어떤 스트림인지, 어떤 포맷으로 내보낼지, 디코딩된 프레임을 어디로 내보낼지”에 관한 부분의 설정이 필요합니다. 다음과 같은 세부 정보들을 요구합니다.
- 디코딩 세션 메모리 할당 방식
- 포맷 정보(어떤 코덱/해상도/파라미터인지)
- 디코더 추가 요구사항
- 디코딩 결과 출력 프레임의 조건(색상 포맷, 해상도 등)
- 디코딩 완료 시 호출할 콜백 함수 포인터
디코딩을 마치면 SBS프레임이 VTDecompressionOutputCallbackRecord에서 CVPixelBuffer로 제공됩니다.
9. MV-HEVC 변환
MV-HEVC 변환을 설명하기 이전에 MV-HEVC가 무엇인지 잠깐 설명하도록 하겠습니다. MV-HEVC는 HEVC를 기반으로 여러 시점을 동시에 압축·복원할 수 있게 만든 다중뷰 영상 코덱입니다. 비전프로에서는 이 포맷을 스테레오 비디오로 렌더링 합니다. 직접 비전프로의 좌안과 우안에 각각 영상을 렌더링 하지 않고도 재생할 수 있도록 Apple에서 제공합니다.
MV-HEVC는 스테레오 영상 뿐만 아니라 여러 시점의 영상을 담을 수 있도록 설계된 코덱입니다.

MV-HEVC는 양안 뿐 만 아니라, 다양한 시점의 영상을 담을 수 있습니다. 현재 HIPPO에서는 LeftAndRightViewIDs는 사용하고 있지 않습니다.
변환 과정의 큰 흐름은 다음 이미지와 같습니다.

‘프레임 분할’ 부터 ‘출력버퍼에 전달’까지의 과정이 MV-HEVC의 핵심 과정이 됩니다. 이는 VideoToolBox의 메서드인 VTPixelTransferSessionTransferImage에 의해 이루어집니다.

- VTPixelTransferSesion 객체(어떤 방식으로 픽셀을 변환, 복사할지)
- 원본 픽셀 버퍼: CVImageBuffer
- 변환된 픽셀이 기록될 버퍼: CVPixelBuffer
마찬가지로 세션 구성을 진행합니다. VTPixelTransferSessionCreate에서는 다음 값들을 요구합니다.
- 세션 메모리 할당 방식
- 생성된 VTPixelTransferSession 객체를 반환받는 포인터
보시다시피, 픽셀 변환 세션 생성 시에는 특별한 설정이 없습니다. 대신 VTSessionSetProperty를 통해 상세 설정을 합니다.
- VTPixelTransferSession 객체
- 어떤 방식으로 입력 픽셀을 변형할지
- 해당 VTSessionSetProperty의 구체적인 설정값 → 입력 소스를 cleanApeture 기준으로 크롭
이 때, clenaApeture 관련 설정은 주로 다음 4가지에 해당합니다.
- kCVImageBufferCleanApertureWidthKey: 폭(가로사이즈)
- kCVImageBufferCleanApertureHeightKey: 높이(세로사이즈)
- kCVImageBufferCleanApertureHorizontalOffsetKey: 수평오프셋(가로 시작지점)
- kCVImageBufferCleanApertureVerticalOffsetKey: 수직오프셋(세로 시작지점)
예를 들어, 만약 38401080의 SBS영상을 두 개의 19201080영상으로 분할하고 싶다면 각 값은 다음과 같아집니다.
좌안
- 가로사이즈: (원본영상 가로 사이즈)/2
- 세로사이즈: (원본영상 세로 사이즈)
- 수평오프셋: 0
- 수직오프셋: 0
우안
- 가로사이즈: (원본영상 가로 사이즈)/2
- 세로사이즈: (원본영상 세로 사이즈)
- 수평오프셋: (원본영상 가로 사이즈)/2
- 수직오프셋: 0

이후, CVBufferSetAttachment 메서드를 이용하여 이 설정을 번갈아가면서 원본 픽셀버퍼에 부착해 줍니다. 그러면 VTPixelTransferSessionTransferImage에서 원본 픽셀버퍼를 인자로 받아서 설정값 범위만큼 프레임을 분할합니다.
마지막으로 분할된 CVPixelBuffer 프레임에 앞서 언급했던 layerId와 viewId, 그리고 미디어타입을 태깅한 후 하나의 CMSampleBuffer로 재조립을 진행합니다.
10. 3D 영상 재생
마지막입니다. 이렇게 분할된 프레임 정보를 담고 있는 CMSampleBuffer는 AVSampleBufferVideoRenderer의 enqueue 메서드를 이용하여 출력 준비를 마칩니다. 이 렌더러는 RealityView 내 엔티티의 VideoPlayerComponent에 연결되어 있습니다. 태깅 값에 따라 프레임이 각 눈으로 자동으로 분기되어 렌더링되고, 최종적으로 3D 영상이 출력됩니다.
더 정확하고 자세한 내용을 원하신다면 다음 애플 공식문서들을 참고해 주세요.
멀티뷰 HEVC 변환 관련
카메라 영상 연결 관련
메타데이터
- post_id
- 48ab0140e749
- slug
- hippo는-vision-pro에서-3d내시경-영상을-어떻게-출력하나요-48ab0140e749
- url
- https://medium.com/hungry-hippo/hippo%EB%8A%94-vision-pro%EC%97%90%EC%84%9C-3d%EB%82%B4%EC%8B%9C%EA%B2%BD-%EC%98%81%EC%83%81%EC%9D%84-%EC%96%B4%EB%96%BB%EA%B2%8C-%EC%B6%9C%EB%A0%A5%ED%95%98%EB%82%98%EC%9A%94-48ab0140e749
- canonical_url
- https://medium.com/hungry-hippo/hippo%EB%8A%94-vision-pro%EC%97%90%EC%84%9C-3d%EB%82%B4%EC%8B%9C%EA%B2%BD-%EC%98%81%EC%83%81%EC%9D%84-%EC%96%B4%EB%96%BB%EA%B2%8C-%EC%B6%9C%EB%A0%A5%ED%95%98%EB%82%98%EC%9A%94-48ab0140e749
- author_url
- https://medium.com/@opunundo
- status
- ok
- fetched_at
- 2026-06-11 18:08:35


