Apache Kafka Components Explained in One Picture
Apache Kafka is a distributed event streaming platform
Apache Kafka Components Explained in One Picture
Apache Kafka is a distributed event streaming platform
Kafka คือ แพลตฟอร์มที่ถูกออกแบบมาเพื่อใช้ในงานในระบบที่ต้องจัดการกับข้อมูลที่ไหลเข้ามาแบบต่อเนื่อง (Event streaming) โดย Kafka จะทำหน้าที่เป็นตัวกลางที่คอยรับและเก็บข้อมูลเหล่านั้นชั่วคราว ก่อนที่ระบบปลายทางหลายๆ ระบบจะมาดึงข้อมูลจาก Kafka ไปใช้งานต่อ เช่น การรับข้อมูล log จากพฤติกรรมผู้ใช้งานบนเว็บไซต์มาเก็บไว้ที่ Kafka ก่อนแล้วระบบต่าง ๆ ที่เกี่ยวข้อง เช่น ระบบวิเคราะห์ข้อมูล ระบบแจ้งเตือน และระบบ Dashboard สามารถดึงข้อมูลเดียวกันนี้ไปใช้งานต่อได้พร้อมกันแบบ real-time โดยไม่รบกวนกัน

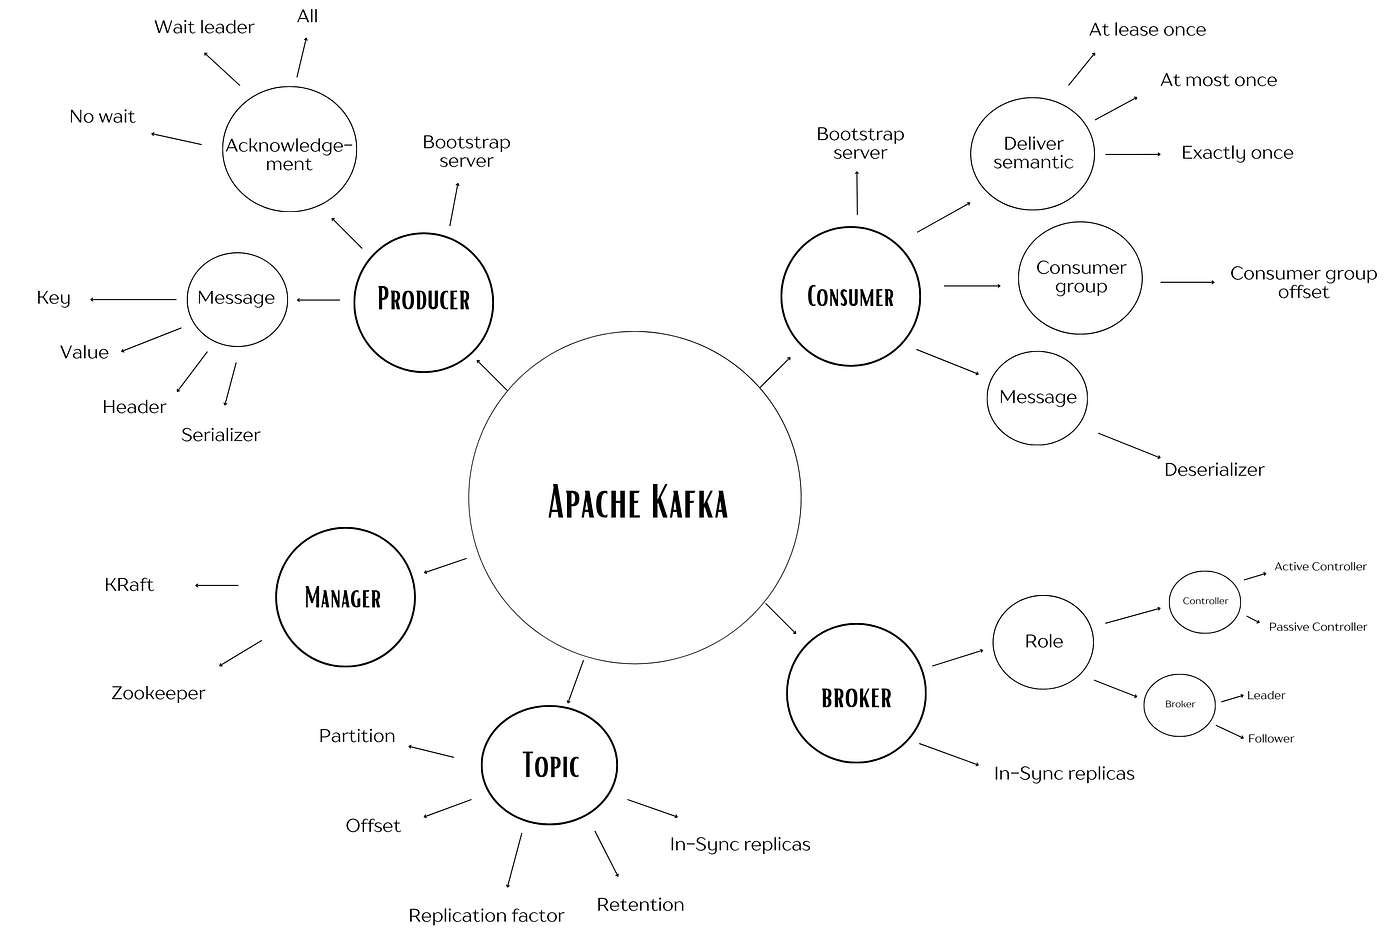
ในบทความนี้ เราจะมาทำความรู้จักกับองค์ประกอบหลักของ Kafka และทำความเข้าใจว่าทำไมมันถึงเป็นหัวใจสำคัญของ Event-Driven Architecture โดยส่วนประกอบหลักของ Kafka เพื่อความเข้าใจง่ายแล้วผมขอแบ่งออกเป็น 5 ส่วนหลัก ๆ อันได้แก่ Topic, Producer, Consumer, Broker และ Manager
เรามาทำความรู้จักกับแต่ละส่วนกันเลย
1. Topic

Topic ใน Kafka คือส่วนที่ไว้ใช้สำหรับเก็บข้อมูล โดยถ้าเปรียบเทียบกับ Relational Database ก็จะเปรียบเหมือนกับ Table แต่…
ข้อแตกต่างระหว่าง Kafka Topic และ Table
ไม่มี Query แบบ Traditional Database
- Kafka ตัวเองไม่มี query engine
- ไม่สามารถ random access หรือ index-based lookup
- แต่สามารถใช้ ksqlDB หรือ Kafka Streams เพื่อ query real-time ได้
Immutable (แก้ไขไม่ได้)
- เขียนลงไปแล้วไม่สามารถ Update หรือ Delete ได้
- เหมือนการบันทึกประวัติ เมื่อเกิดขึ้นแล้วข้อมูลที่เขียนลงไปใน Topic แล้วจะไม่สามารถแก้ไขได้
การลบใช้ Retention Policy
- ไม่ได้ลบทีละ Record แต่จะเป็นลบตามเวลาหรือขนาดที่ตั้งไว้ (Retention)
- ตั้ง Retention เช่น “เก็บ 7 วัน” หรือ “เก็บ 100GB”
- Kafka ลบข้อมูลเก่าอัตโนมัติตาม policy
ส่วนประกอบของ Topic
1.1 Partition
ภายใน Topic จะมี Partition ไว้สำหรับช่วยกระจายการทำงาน ทำให้ในหนึ่ง Topic สามารถรองรับ Service ที่เข้ามาเขียนและอ่านข้อมูลแบบคู่ขนานกัน โดยการกำหนดจำนวน Partition ให้เหมาะสมกับจำนวน Event ที่เข้ามาใน Topic จะช่วยเพิ่มความสามารถในการเขียนและอ่านข้อมูลจาก Topic ได้รวดเร็วมากยิ่งขึ้น

1.2 Offset
จะเป็นตัวแสดงถึงตำแหน่งปัจจุบันในแต่ละ Partition ว่าแต่ละ Consumer อ่านไปล่าสุดถึงตรงไหนแล้ว เพื่อป้องกันตอนที่ Consumer นั้น ๆ เกิดพังไป แล้วมี Consumer ใหม่มาแทนที่ ก็จะได้อ่านข้อมูลในลำดับถัดไปต่อได้เลย

1.3 Replication factor
เป็น Configuration ที่เอาไว้ เพื่อการเพิ่มความมั่นใจในการเก็บข้อมูลของแต่ละ Partition ว่าจะมีการทำสำเนาเก็บไว้กี่ชุด โดยถ้า set ไว้เท่ากับ 1 หมายความว่าจะมีข้อมูลของ Partition แค่ 1 ชุดเท่านั้น (ไม่มีสำเนา)
1.4 Retention
ตัวเลขที่ระบุถึงอายุที่จะเก็บข้อมูลไว้ใน Kafka มีไว้เพื่อช่วยในการจัดการการใช้พื้นที่บน Disk ของ Kafka เพื่อที่จะได้ลบข้อมูลที่ไม่มีคนใช้งานแล้วออกไป โดยเราสามารถตั้งเงื่อนไข ได้ 2 แบบคือ ตามอายุ (millisecond) กับ ตามขนาด (byte)
1.5 In-sync replicas
คือ List รายชื่อของ Kafka Server (Broker) ทั้งหมดที่กำลังทำหน้าที่เก็บสำเนาข้อมูลใน Partition นี้อยู่
- การ config
min.insync.replicasเป็นอีกหนึ่งใน Configuration ที่ไม่ควรมองข้าม เพราะเป็นตัวกำหนดถึงจำนวน Kafka Server (Broker) ขึ้นต่ำที่ต้องทำสำเนาข้อมูลของแต่ละ Partition ไว้เพื่อช่วยป้องกันเวลาที่มี Server พังเราจะได้มีข้อมูลสำรองไว้ใช้งาน
2. Producer

Producer คือ Application หรือ Service ที่ส่งข้อมูลไปยัง Kafka Topic โดยในการที่จะสร้างข้อมูลเข้าไปยัง Topic ได้นั้น จะต้องมีการ Setup เบื้องต้นดังนี้
2.1 Producer Configuration

2.1.1) Bootstrap server เป็น Configuration ที่ระบุถึง Kafka Server (Broker) ซึ่ง จะใช้ตอนที่ Service ของ Producer กำลังเริ่มต้นเชื่อมต่อไปหา Kafka Server เพื่อดึงข้อมูลรายละเอียดของ Kafka Cluster (Metadata) เพื่อใช้ต่อในตอนที่จะส่ง Event ไปเก็บใน Kafka
2.1.2) Acknowledgement เป็น Configuration ที่บอกว่า Kafka Server (Broker) จะตอบกลับเมื่อไหร่ โดยมีทั้งหมด 3 แบบ คือ All, Wait leader และ No wait
- All (acks=all หรือ -1) : รอจนกว่า Brokers ทั้งหมดจะเขียนข้อมูลเสร็จค่อยตอบกลับ โดย default จะเป็นค่านี้
- Wait leader (acks=1) : รอเฉพาะ Broker ที่ทำหน้าที่เป็น partition leader ของ partition นั้น ๆ เขียนข้อมูลเสร็จ แล้วจึงตอบกลับ
- No wait (acks=0) : ตอบกลับทันที ไม่ต้องรอ
2.2 Producer Message
คือ ข้อมูลที่จะถูกส่งเข้ามาเพื่อเก็บใน Kafka โดยโครงสร้างคร่าว ๆ จะประกอบด้วย

2.2.1) Key คือ ข้อมูลที่จะใช้สำหรับการเลือก Partition โดยเราสามารถระบุ Key ให้กับ Event เพื่อให้ Event ที่มี Key เดียวกันได้ถูก Produce ไปลง Partition เดิมเสมอ แต่ถ้าหากเราไม่ได้ระบุ Message Key โดย default ตัว Event จะถูก Produce ไปยัง Partition โดยใช้วิธี Sticky partitioner ในการช่วยเลือก Partition ซึ่งถ้าใครสนใจเรื่อง Sticky partitioner สามารถอ่านรายละเอียดได้จาก ที่นี่
2.2.2) Value คือ ข้อมูลที่เราต้องการจะเก็บไว้ใน Kafka โดยอาจจะเป็นรูปแบบ Plain text, Photobuf, CSV และอื่น ๆ
2.2.3) Header คือ Key-Value pairs เพื่อใส่ข้อมูล additional ที่อาจจะต้องใช้งานในฝั่ง Consumer อย่างเช่น tracing, correlation-id เป็นต้น
อีกหนึ่งสิ่งที่สำคัญของ Producer Message คือ จะต้องมีการระบุ Serializer ให้กับ Key และ Value เสมอ เพื่อให้ Producer สามารถแปลงข้อมูลไปเป็น Binary ได้ถูกต้องตรง Format เพราะว่าข้อมูลที่เก็บไว้ภายใน Kafka จะเป็นรูปแบบ Binary
3. Consumer

Consumer คือ Application หรือ Service ที่เข้ามาดึงข้อมูลจาก Kafka ไปใช้งานต่อ โดยการที่จะเข้ามายัง Kafka Server เพื่อดึงข้อมูลไปใช้งานต่อได้ก็จะต้องมีการ Setup เบื้องต้นดังนี้
3.1 Consumer Configuration

3.1.1) Bootstrap server เป็น Configuration ที่ระบุถึง Kafka Server (Broker) เช่นเดียวกับ Bootstreap server ของฝั่ง Producer โดยฝั่งของ Consumer เองก็จะมีการเชื่อมต่อไปหา Kafka Server เพื่อดึงรายละเอียดของ Kafka Cluster (metadata) เพื่อใช้ต่อในการที่จะดึง Event มาใช้งานต่อ
3.1.2) Consumer group เป็น Configuration ที่จะช่วยเพิ่มความสามารถในการประมวลผลแบบขนานกันได้ โดยแทนที่จะมี Consumer คนเดียวมาดึงข้อมูลจาก Kafka Topic เราสามารถเพิ่ม Consumer หลายๆ ตัวมาช่วยกันได้ โดยจะมีกฏสำคัญข้อนึงคือ ภายใน Group
- 1 Partition จะถูกดึงข้อมูลโดย 1 Consumer เท่านั้น
- เมื่อ Consumer ตัวใดตัวหนึ่งล่มไป Kafka จะย้ายการดึงข้อมูลของ Partition ที่มันเคยดูแลอยู่ ไปให้ Consumer ตัวอื่น ๆ ที่ยังทำงานได้อยู่แทนโดยอัตโนมัติ
3.1.3) Delivery semantic เป็น Configuration ที่ไว้บอกว่าข้อมูลจะถูกประมวลผลจาก Consumer กี่ตัวก่อนที่จะ Commit เพื่อจะขยับ Offset ที่เก็บไว้ใน Kafka Server ไปยังเลขถัดไป โดยจะมีทั้งหมด 3 รูปแบบ คือ
- At lease once : ประมวลผลข้อมูลให้เสร็จก่อนแล้วค่อย Commit Offset
- At most once : Commit Offset ก่อนประมวลผล
- Exactly once : ใช้ Transaction หรือ Idempotent Consumer ในการจัดการ เพื่อให้มั่นใจว่าข้อมูลจะถูกประมวลผลแล้วค่อย Commit Offset
3.2 Consumer Message
คือ ข้อมูลที่ดึงออกมาจาก Kafka Topic โดยจะมีโครงสร้างเดียวกันกับ Producer Message แตกต่างกันเฉพาะฝั่ง Consumer จะเป็นฝั่งของการดึงข้อมูลมาใช้งาน ดังนั้น จะต้องมีการระบุ Deserializer ให้กับ Key และ Value ด้วยเพื่อให้สามารถแปลง Binary ที่อยู่ใน Kafka Topic กลับมาเป็นข้อมูลได้ถูกต้อง
4. Broker

Broker หรือ Kafka Server คือศูนย์กลางที่ทำหน้าที่ในการจัดเก็บและจัดการข้อมูลต่าง ๆ ภายใน Cluster โดยมีหน้าที่คร่าว ๆ ดังนี้
- เก็บและจัดการข้อมูล Event
- เป็นตัวกลางในการรับข้อมูลจาก Producer
- เปิดช่องทางให้ Consumer เข้ามาดึงข้อมูลไปใช้งานต่อ
- ทำการ Replication Data เพื่อเพิ่มความปลอดภัยของข้อมูล
- จัดการข้อมูลของ Topic, Partition และ Offset
โดย Broker ทุกตัวเราจะต้องมีการ Setup เบื้องต้นได้แก่
4.1 Role
ใน Kafka Cluster จะมีการกำหนด Role ให้กับ Broker โดยสามารถแบ่งออกได้เป็น สองแบบคือ Controller และ Broker
Role: Broker
คือ เครื่อง Broker ที่ทำหน้าที่ในการบันทึกและจัดการข้อมูลของแต่ละ Partition โดยแบ่งย่อยเป็น 2 แบบคือ
- Leader คือ Broker ที่คอยรับข้อมูลจาก Producer มาและบันทึกเข้าไปใน Kafka และเปิดให้ Consumer มาดึงข้อมูลไปใช้งานต่อได้
- Follower คือ Broker ที่ Repilcation ข้อมูลของ Partition ไว้ เผื่อ Leader พังไปจะมีโอกาสถูกเลือกขึ้นเป็นเครื่อง Leader ได้
Role: Controller
คือ เครื่อง Broker ที่ทำหน้าในการจัดการ Metadata ของ Cluster และคอย Monitor และเลือกว่าใครจะเป็น Leader ของแต่ละ Partition และเมื่อมีการเพิ่มลดจำนวน Broker ตัว Controller ก็จะเป็นคน Rebalance Partition ให้เหมาะกับจำนวน Broker ตัว Role ของฝั่ง Controller เองก็สามารถแบ่งเป็น 2 แบบคือ
- Active Controller คือ ตัวหลักที่ทำหน้าที่เป็น Controller อยู่ในปัจจุบัน ซึ่งมีได้แค่ 1 ตัวเท่านั้น
- Passive Controller คือ ตัวสำรองที่คอย Replication ข้อมูลของ Controller อยู่เพื่อตอนที่ Active Controller พังไป จะได้ขึ้นเป็น Active ตัวใหม่ได้ทันทีโดยคนที่ทำหน้าที่เป็นคนเลือก Controller คือ Manager
4.2 In-Sync replicas
คือ List รายชื่อของ Kafka Server (Broker) ทั้งหมดที่กำลังทำหน้าที่เก็บสำเนาข้อมูลใน Partition นี้อยู่ ซึ่งจะเหมือนกับที่อธิบายไปตอนต้นที่หัวข้อ Topic ซึ่งถ้ามีการ Setup ไว้ทั้งที่ Topic และ Broker ก็จะยึดจากที่ Topic เป็นหลัก เพราะ Priority ของ Topic สูงกว่า
5. Manager

มาถึงส่วนสุดท้ายกันแล้ว นั่นคือ Manager ซึ่งโดย Document ของ Kafka เองไม่ได้เรียกส่วนนี้ว่าเป็น Manager และก็ยังไม่เจอชื่อเรียกที่ชัดเจนนัก แต่ด้วยหน้าที่ที่เป็นคนคอยประสานงานให้การทำงานภายใน Cluster เป็นไปได้อย่างราบรื่นผมเลยเปรียบตัว Zookeeper และ KRaft เป็น Manager แทนนะครับ
5.1 Zookeeper
Zookeeper คือ Service ที่ไว้ใช้จัดการ Configuration และ Metadata ต่าง ๆ ของ Kafka และยังเป็นตัวที่คอยบอกทางให้กับ Client เพื่อตามหา Broker ที่ทำหน้าที่เป็น Leader ปัจจุบันของแต่ละ Partition ด้วย รวมทั้งคอยจัดการการ Broker คอย Monitor, เลือก Broker ที่จะทำหน้าที่เป็น Controller
5.2 KRaft
KRaft เป็นโหมดใหม่ของ Kafka ที่ถูกออกแบบมาแทนที่การใช้งาน Zookeeper ในการจัดการ Metadata ทั้งหมดของ Kafka ทำให้ไม่ต้องติดตั้งและดูแล Zookeeper Cluster แยกต่างหากอีกต่อไป ช่วยลดความซับซ้อน และปัญหา Latency ระหว่าง Kafka และ Zookeeper
ข้อจำกัด Zookeeper
- ต้องติดตั้งและดูแล Zookeeper Cluster แยกต่างหาก
- Metadata operation มี latency ที่สูงเพราะต้อง round-trip ไป Zookeeper
- การเลือก Controller จะทำผ่าน Zookeeper ทำให้ Failover ช้าขึ้น
KRaft มาแก้ปัญหาเหล่านี้โดยการเพิ่มการเก็บและจัดการ Metadata มากับ Kafka Broker เลยไม่ต้อง Setup หรือสร้าง Cluster แยกอีกต่อไป และเพิ่มการใช้ Kafka’s Raft ซึ่งเป็น Consensus Algorithm ที่พัฒนาต่อจาก Raft มาเป็นตัวช่วยในการตัดสินใจเลือกว่าจะให้ Broker ไหนรับ Role เป็น Active Controller ได้อย่างรวดเร็วและเสถียร
KRaft ได้รับการประกาศว่าเป็น Production ready ตั้งแต่ Apache Kafka 3.3 เป็นต้นไป โดยคาดว่า Zookeeper จะถูก deprecate (เลิกใช้) ทั้งหมดใน version 4.0 ขึ้นไป
Kafka in Advanced
นอกจากส่วนประกอบหลักที่กล่าวถึงไปแล้ว Kafka ยังมี Components เสริม ที่ออกแบบมาเพื่อตอบโจทย์ระบบ Always-On ซึ่งต้องทำงานต่อเนื่องและรองรับปริมาณข้อมูลขนาดใหญ่ ตัวอย่างที่น่าสนใจ ได้แก่
- Kafka Streams — Library สำหรับการประมวลผลข้อมูลแบบ real-time
- Kafka Connect —Framework สำหรับเชื่อมต่อ Kafka กับระบบภายนอก เช่น Databases, File systems, หรือ Messaging systems
Course
https://www.coursera.org/learn/packt-apache-kafka-series-learn-apache-kafka-for-beginners-v3-cjher
Reference
[embed]Apache Kafka Apache Kafka: A Distributed Streaming Platform.kafka.apache.org
[embed]Home - Conduktor documentation Edit descriptionlearn.conduktor.io
메타데이터
- post_id
- 6080b03285d9
- slug
- apache-kafka-components-explained-in-one-picture-6080b03285d9
- url
- https://medium.com/odds-team/apache-kafka-components-explained-in-one-picture-6080b03285d9
- canonical_url
- https://medium.com/odds-team/apache-kafka-components-explained-in-one-picture-6080b03285d9
- author_url
- https://medium.com/@pumsdev
- status
- ok
- fetched_at
- 2026-07-14 14:55:07