Desbravando a interseção entre Computação Gráfica e Programação Funcional
Escrito por: João G. Bruni e Thiago Calile Costa
Desbravando a interseção entre Computação Gráfica e Programação Funcional
Escrito por: João G. Bruni e Thiago Calile Costa
Introdução
Neste breve experimento literário (artigos são literatura??) vamos trazer aos holofotes uma pergunta um tanto vaga que é perfeitamente representada da seguinte forma animalesca: “shippar renderização com paradigma funcional é based ou cringe?”
Como você já deve ter percebido pela frase anterior, o artigo que você está prestes a ler não se leva tão a sério. Nós até temos compromisso com a verdade, mas não iremos citar o [Zhang et al.] a cada frase escrita, então fique à vontade para manter o ceticismo em alguma afirmação que achar duvidosa. Nossa proposta é explorar um tema meio aleatório que despertou nosso interesse ao ponto de acharmos legal escrever sobre ele. Se você é uma pessoa curiosa, esperamos que essa leitura lhe traga algum valor!
Motivação
Se tem duas coisas que são muito iradas no mundo da programação, essas duas coisas são Computação Gráfica (CG) e Programação Funcional (PF). A primeira nos proporciona uma forma de criar obras de arte fantásticas (como videogames e filmes) através da matemática, enquanto a segunda consegue transformar um código já simples como esse:
// Filtrando numeros pares de uma lista em Java
List < Integer > evens = new ArrayList < >() ;
for ( Integer n : numbers ) {
    if (n % 2 == 0) {
        evens . add (n);
    }
}
Em uma belezura dessas:
-- Fazendo o mesmo , mas dessa vez em Haskell
getEvens :: [ Int ] -> [ Int ]
getEvens numbers = filter even numbers
Como entusiastas de ambos os temas, uma pergunta que surge naturalmente em nossas cabeças é:
Como é programar na interseção destes universos?
E para além disso,
Por que o mundo da CG é tão imperativo e orientado a objetos?
Este é o tipo de pergunta que tentaremos responder até o final dessa mini-aventura!
Paradigmas de Programação
Para começar com o clássico e com o óbvio, vamos tirar a polêmica da frente: cada paradigma de programação têm o seu mérito e o seu lugar. Não iremos defender aqui que aplicações gráficas deveriam ser escritas no paradigma funcional — apenas iremos investigar se essa combinação fica saborosa ou não. Se você já está bem conceituado no que diz respeito a paradigmas de programação, então pode pular sua leitura para a próxima seção.
Dito isso, precisamos antes definir as diferenças principais entre PF e POO para os não iniciados. A principal diferença fica explícita quando analizamos a “genealogia” desses paradigmas, digamos assim. A POO é um sub-paradigma da programação imperativa, enquanto a PF é um sub-paradigma da programação declarativa.
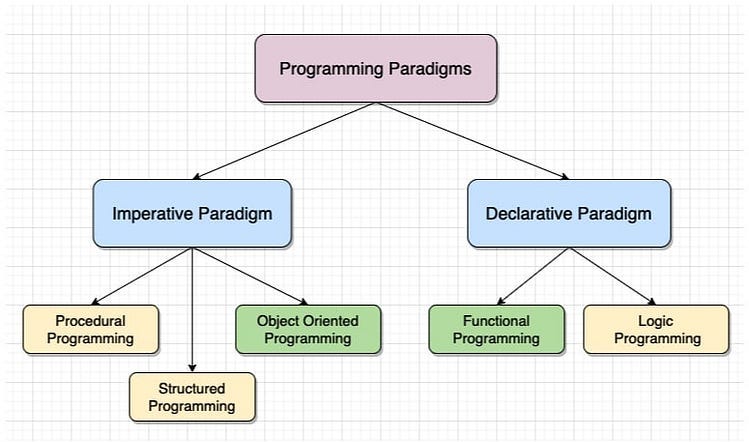
Mapa dos Paradigmas de Programação. Créditos da imagem: Ario Liyan (https://medium.com/@Ariobarxan/what-is-a-programming-paradigm-ec6c5879952b)
Ok, mas e a diferença entre o imperativo e o declarativo? Filosoficamente, podemos dizer que um código imperativo diz ao computador como fazer uma série de operações para se chegar a um resultado, enquanto um código declarativo diz ao computador o que é o resultado em termos das operações necessárias para chegar nele. Além disso, é interessante a nós já apontarmos que linguagens declarativas tendem a ser um pouco mais alto nível, pois nelas o detalhamento de como o programa deve rodar precisa ser gerado a partir da descrição do que se quer alcançar, faz sentido? Ou seja, podemos dizer que as linguagens assembly são o epítome da programação imperativa, já que elas quase perfeitamente mapeiam o passo a passo de como o processador deve operar.
Essa distinção é bastante abstrata, então bora trazer um outro ponto um pouco mais concreto: a POO foca mais nos estados, enquanto a PF foca mais nas funções. É quase místico como a dualidade objeto-verbo abrange tudo em nossa vida se você parar para pensar, mas se esse papo continuar a gente vai perder o fio da meada.
A pri: ncipal proposta da POO é possibilitar que um(a) programador(a) mapeie o domínio do seu problema (por exemplo, uma doceria) de forma mais direta e intuitiva no código. Para isso, cada coisa que nós enxergamos como sendo um “objeto” naquele domínio pode se tornar também um objeto no programa — basta que você encapsule seus estados e comportamentos em uma classe. No caso da doceria, o conceito “doce” pode ser uma classe, e ela pode ter como propriedades os seus ingredientes, e como comportamentos… o que quer que seja que doces fazem. A partir daí a gente chega também nos demais conceitos da POO, como a herança — pensando que podem existir classes de doces mais específicos, como o Bolo — mas este exemplo está indo longe demais e isso aqui não é um curso de POO.
Fonte: https://corporate.sanrio.co.jp/en/sanriotimes/20251003.html
Enfim, esta ideia de podermos encaixar o código na nossa visão de mundo e vice-versa é muito interessante e potente, mas ela vem com alguns contrapontos. O principal é que nem sempre a nossa forma de segregar objetos da vida real é também o melhor jeito de tratá-los dentro de um programa. Toda vez que definimos uma classe X, estamos dizendo que X é um “todo” mereológico composto por seus atributos e métodos; mas infelizmente a mereologia é uma área da filosofia que, como todas as outras, está em aberto. O que é um “todo” (uma classe ou objeto) é algo muito arbitrário — nós estamos criando uma barreira entre aquela amálgama de características e o resto do mundo, mas o que me garante que uma barreira que faz sentido no mundo real vai ser traduzida para uma barreira que me ajuda a resolver um problema no código? Nós humanos dizemos que um doce é um objeto por que nosso cérebro foi configurado para enxergar o universo assim, mas computadores não possuem cérebros. Os primeiros minutos dessa palestra do Casey Muratori cagando na cabeça da POO ilustra bem este ponto.
Do outro lado do ring temos a programação funcional. Enquanto na POO estamos focados em encapsular estados, na programação funcional não existe estado. Bom, não é bem assim, é claro. O que não existe é estado mutável compartilhado; em suma, variáveis. A principal proposta da PF é que todas as funções sejam puras. Funções puras são funções determinísticas, e que portanto não produzem efeitos colaterais no restante do programa. Elas são literalmente funções matemáticas: o que sai delas depende única e exclusivamente do que foi passado como argumento, elas não acessam nenhum dado externo. Pense assim: se elas utilizassem variáveis externas, como um estado global, e fossem capazes também de modificá-lo (ou seja, gerar efeitos colaterais), nada nos garantiria que chamar a função com os mesmos argumentos produziria o mesmo resultado, pois este estado global poderia influenciar o resultado sem que a gente soubesse.

XKCD 1312
Outra parte importante da PF é que ela gira em torno da composição de funções. Todo programa, independentemente do paradigma, no fim do dia é um encadeamento de processos, funções, operações. Contudo, na PF isso fica muito mais explícito.
Como é de se imaginar, os problemas da PF surgem quando nosso domínio, problema ou universo é inerentemente ou intuitivamente melhor representado com estados mutáveis. Já puxando o gancho da CG aqui, é bem possível que o universo da renderização seja um desses casos. Afinal de contas, nós renderizamos objetos, e não processos. Vértices, cores, curvas, superfícies, modelos3D, texturas, será que eles precisam mesmo ser objetos? Nós sabemos que é sim muito conveniente representar estas abstrações como classes, mas outro aspecto muito importante da CG é como esses dados se transformam. Toda a ideia da CG gira em torno de fazermos uma série de transformações (pense em composição de funções) e cálculos, saindo dos vértices e chegando a uma imagem. Se a PF costuma se sair tão bem em contextos de transformações e cálculos encadeados, então por que não temos ainda uma API gráfica funcional dominando o mundo?
Por que POO Domina tanto o cenário?
Interessantemente, a união entre computação gráfica e orientação a objetos data desde antes de qualquer um dos dois ser consolidado como disciplina, por conta de um programa chamado Sketchpad. O Sketchpad foi um programa desenvolvido por Ivan Sutherland em 1963 no MIT que estava muito a frente de seu tempo. Basicamente, ele era um software de criação de designs/desenhos que te permitia manipular a geometria desenhada de formas muito inteligentes (se você quiser ver o programa em ação, aqui vai um ótimo vídeo no YT de uma reportagem feita sobre o Sketchpad pouco após sua criação).

Este programa introduziu conceitos que mais tarde foram usados e adaptados na linguagem Simula 67, que por sua vez influenciou o Smalltalk, que é mais amplamente vista como a ancestral das linguagens orientadas a objeto, por amadurecer e levar o paradigma ao seu extremo, além de ter inspirado mais diretamente linguagens famosas como C++, Java e até mesmo Python.
Enfim, o ponto principal é: não é nem um pouco recente a ideia de criar aplicações gráficas utilizando POO. O próprio Smalltalk ditou como GUIs eram escritas, sendo o pioneiro do padrão MVC. Contudo, acreditamos que haja pelo menos outros dois motivos bem convincentes para este pacto satânico:
• Bola de neve • Acessibilidade
Primeiramente, podemos falar da bola de neve. Olha… PF sempre foi um tópico meio acadêmico e teórico, ninguém na história da indústria dos softwares jamais disse “acho que é uma boa usamos *Elm* como linguagem principal”. Ok, isso foi um pouco exagerado, mas o ponto é válido.
A linguagem mais influente da história ( C ) é imperativa, e seu sucessor direto (C++), é orientado a objetos. A partir desse ponto, basicamente toda linguagem que surge e que possui investimento suficiente para se tornar comercialmente viável pega inspiração dessa família, e nada sobra para os betas funcionais.
Segundamente, um fator que com certeza reduz e muito a propagação do góspel é a acessibilidade - e isso se mistura com o tópico da bola de neve, veja só. A programação funcional tem um rosto muito mais “matemático” que a POO. A programação funcional surge a partir do Cálculo Lambda, um ramo da matemática criado (ou descoberto??) por Alonzo Church na década de 30, e possui muito fundamento na Teoria das Categorias — uma outra área da matemática muito conhecida por ser um inferno, e de onde vêm o famoso termo-bixo-papão “Monad” (mônade ou mônada em português).

Diagrama menos apavorante encontrado em um livro de Teoria das Categorias
Em comparação com a orientação a objetos, que surge da ideia de tornar tudo mais intuitivo, fica claro qual paradigma é mais amigável para nós humanos. Isso pode até parecer elitismo, mas não, é realmente um ponto fraco da PF: sua sintaxe geral e sua forma de ser escrita demandam uma boa curva de aprendizado, e é aí que entra a bola de neve novamente. Para quem está acostumado a escrever código imperativo e procedural, é necessária uma “reconexão de neurônios” ferrada para alcançar um nível produtivo na PF. Este é um esforço que muitas vezes não vale a pena para a maioria das pessoas, e isso é totalmente compreensível, já que os outros paradigmas são completamente capazes de fazer qualquer computação, obviamente.
Como um adendo, vale a pena também falarmos de performance. Como você deve imaginar, aplicações gráficas, e principalmente jogos, possuem uma grande pressão para executarem rápido pra burro. Se PF implicasse em código lento, faria muito sentido sua rejeição, mas não é bem assim que a banda toca. Por conta da pressão por perfórmance, linguagens com Garbage Collectors são por vezes uma escolha questionável. Infelizmente, praticamente todas as linguagens que seguem o paradigma funcional e são minimamente populares possuem garbage collection (Elixir, Erlang, Clojure, Haskell, OCaml, F#, …). Apesar disso, C# — que também tem um coletor de lixo parrudo — é amplamente utilizado na criação de jogos, ora ora. Para além disso, os gargalos de performance na CG muitas vezes não vão surgir do que está rodando na CPU (seu código orientado a objetos), mas sim do que está rodando na GPU (provavelmente GLSL, que também não é funcional, mas já já falamos sobre isso). E tem mais!!! Dizem as más linguas que códigos escritos com PF são naturalmente mais amigáveis com a localidade de cache e com paralelismo. Hoje em dia, linguagens como Haskell, apesar de serem mais alto nível, possuem ótimos compiladores e conseguem executar quase tão rápido quanto C++ ou Rust. Ou seja, muito provavelmente performance não é parte tão significativa dessa equação.
Focando no que importa, todos estes motivos são também aplicados no caso da computação gráfica em específico. As primeiras APIs gráficas (como o OpenGL, em 92) foram escritas em C, e o motivo é claro: C está em todo lugar (principalmente nos SO’s, que é onde importa) e roda em qualquer lasca de silício — por que raios seria usada outra linguagem? Desde então, nada mudou, porque simplesmente não há razão suficiente para que mude.
Nesta entrevista, Simon Payton fala sobre como seria bom reescrever a infraestrutura de software global usando Haskell por motivos de segurança, mas o Rust já embarcou nessa missão. Para piorar a situação, as linguagens de shader, como o GLSL anteriormente mencionado, foram feitas quase que completamente nos moldes do C, aparentemente apenas porque era a linguagem com a qual todo mundo já estava acostumado…
Simon Peyton
Como Anda a Programação Funcional?
Podemos separar a história deste paradigma em quatro momentos interessantes:
- A definição dada pelo orientador de Alan Turing, o Alonzo Church;
- O surgimento de LISP e seus infinitos dialetos;
- O surgimento e preferência de uso por linguagens orientadas a objetos;
- O paradigma funcional hoje.
Em 1936, Alonzo Church, que futuramente se tornaria orientador de Alan Turing, trabalhou em um modelo computacional próprio: o cálculo lambda. Ao mesmo tempo, e sem saber do cálculo lambda, Turing criou o modelo de computação que hoje chamamos de máquina de Turing. Pouco depois, o pupilo, o tutor e mais um cara chamado Stephen Kleene conseguiram desenhar equivalências entre os dois modelos, demonstrando que qualquer problema que pode ser resolvido com uma máquina de Turing, também pode ser resolvido com uma expressão lambda e vice-versa.
Alonzo Church
Sendo essa equivalência comprovada, certas formas poderosas de programação foram criadas. Aliando-se às melhorias em compiladores e interpretadores, assim como técnicas avançadas de parsing de linguagens, houve uma explosão de linguagens de programação. A mais notável para nosso caso foi LISP, que foi lançada em 1958, e cuja sintaxe era tão simples que quase toda e qualquer aplicação tinha seu próprio dialeto. Sendo que, com base nisso, até mesmo a ANSI decretou um dialeto padrão.
Com a popularidade do LISP, ainda mais para aplicações de inteligência artificial, o MIT e a Symbolics criaram e fabricaram máquinas capazes de executar LISP nativamente durante as décadas de 70 e 80. A própria Symbolics, inclusive, possuia uma equipe de desenvolvimento de aplicações gráficas — a Symbolics Graphics Division — que foi pioneira em avanços na área até o início dos anos 90. Essa equipe criou um monte de softwares interessantes, cujos nomes muito criativos começam todos com “S-”, como:
- o S-Paint, para ilustrações
- o S-Geometry, para modelagem 3D
- o S-Render, uma engine de renderização capaz de fazer ray-tracing
- o S-Dynamics, para animação 3D com suporte a simulações físicas
Se você quiser dar uma olhada nesses softwares funcionando, tem uma demo de 1990 disponível no YouTube. No fim, pelas promessas da IA não serem concretizadas, causando seu Segundo Inverno em 1987, tanto a linguagem LISP quanto suas máquinas foram deixadas um pouco de lado. Ainda assim, o interesse no paradigma não morreu. Muito pelo contrário, é nos anos 90 e 2000 que nós vemos o surgimento de grandes linguagens que levam o paradigma funcional mais além (LISP não era tãooo funcional assim, mas dava melhor suporte a funções de primeira classe que C e contemporâneos), como Haskell, OCaml, Erlang, Clojure e Scala. Nessa brincadeira, linguagens imperativas também começam a adotar muitos conceitos da PF, como o Python adotando a palavra-chave “lambda” em 1994, o C++ adotando expressões lambda em 2011, e o Java em 2014, o JS introduzindo suas “arrow expressions” em 2015, etc.

PogChamp sendo modelado no S-Dynamics em 1986
Então, vista a utilidade das funções anônimas e closures, parte do interesse se deu pela computação em nuvem, já que microsserviços podem ser dimensionados dinamicamente segundo a demanda dos usuários, pois a garantia de funcionalidade idêntica pelo paradigma funcional nos permite subir mais ou menos instâncias de máquinas virtuais sem tanta dor de cabeça. O Discord se vale disso com Elixir, assim como Nubank. Esse segundo também usa a linguagem Clojure para complementar partes de sua infraestrutura, assim como o MercadoLivre o faz. Basta ver como esse uso é comum em sistemas elásticos: Erlang, ou Ericsson Language, foi criada em 1986 pela gigante sueca de telecomunicações para tornar seus sistemas de atendimento resilientes às demandas flutuantes.
Ou seja, há sim uso para a programação funcional (até em sistemas escaláveis e de alta performance e paralelismo) nos dias de hoje. Mas o mais interessante disso tudo é ver a tendência que as linguagens tem seguido de adotar funcionalidades da PF. O Rust é um ótimo exemplo disso: é de longe a linguagem mais amada por sua base de usuários e tem fortes influências do OCaml, Haskell e Erlang.
Seguindo essa linha de raciocínio, chega a ser desejável — para nós com interesse em PF — que Rust conquiste bastante espaço na CG, pois talvez ele seja a ponte ou a fagulha que traga uma cara mais funcional para nossas vidinhas (objetivamente) entediantes.
Vantagens da Programação Funcional
Como dito, algumas empresas já demonstram as qualidades inerentes do paradigma. Há ainda de se dizer que o caso das empresas de telecomunicações se valem das linguagens funcionais por manterem o estado limitado a um processo. Pense na ideia de uma conexão IP ou uma ligação celular precisando ser mantida de acordo com as mudanças de roteamento, sem que essa sessão atrapalhe as outras que estão executando.
Então, se há necessidade de manter isolamento entre possíveis sessões, assim como garantias de transformações de dados, é interessante utilizar esse paradigma. Na CG, por muito tempo as questões de paralelismo eram um tanto complicadas, pois a arquitetura do OpenGL (máquina de estados gigante) não combina muito bem com multi-threading. Contudo, hoje em dia temos o tal do Vulkan, que facilita demais essa questão, então creio que não seja exagero sonhar com uma binding de Vukan para alguma linguagem funcional. Opa, calma aí… já existe uma, mesmo que em caráter exploratório! E é para Haskell!!! Não sei como ainda não tinhamos visto isso durante a escrita até o momento, mas isso é fantástico.
Continuando… outra vantagem é que algumas linguagens funcionais carregam consigo ótimos sistemas de tipagem (aqui entra muito do embasamento na teoria das categorias). Esses sistemas são uma das partes mais elogiadas e apreciadas dessas linguagens, tanto que são o motivo de ser tão comum ouvirmos alguma versão da frase “se o código compila, então está matematicamente provado que ele funciona” sendo dita pelos apóstolos da PF (e dizemos amém para o isomorfismo de Curry–Howard).
Essa característica é bem sedutora quando falamos de CG, poder tratar de vértices, cores, tranformações e demais construtos de forma natural e fluente em nosso código — sabendo que o compilador irá nos avisar se estivermos fazendo caquinha — é algo maravilhoso. Debugar aplicações gráficas pode ser um inferno (um inferno até que divertido, mas ainda um inferno), pois boa parte das falhas se manifestam ou como artefatos irritantes ou como um CAOS ABSOLUTO, então ter uma tipagem robusta pode nos ajudar a evitar certos tipos de bug que se manifestariam de forma misteriosa e imprevisível na tela.

Fonte: https://www.pcgamer.com/our-readers-share-the-worst-most-absurd-glitches-theyve-ever-encountered/
Computação Gráfica
Agora, vamos passar um pouco sobre a história da computação gráfica e o hardware, assim como certas características que são benquistas por uma possível API gráfica e são inerentes às linguagens funcionais.
A walk down memory lane (como estamos agora de gráficos?)
Unidades de processamento gráfico (GPUs) sempre existiram em alguma capacidade. Todos os consoles de videogame possuíam uma, assim como os fliperamas e estações de trabalho de CAD ou computação gráfica, como as da Silicon Graphics. Entretanto, foi a partir da série Amiga de computadores que havia, de fato, um computador doméstico com capacidade gráfica. E assim como os consoles de videogame da época, seu chip era baseado em sprites. Pouco depois, o surgimento da VESA também tornou mais fácil a padronização de resoluções das máquinas da época.
Na década de 1990, a SGI criou o padrão OpenGL, começando a surgir sistemas de gráficos 3D em fliperamas, e ao fim da década, em consoles e computadores de ponta. Ao longo da primeira década dos anos 2000, as duas maiores players do mercado atual surgiram: a NVidia e a ATi (futuramente adquirida pela AMD). A partir dessa época é que surgem as GPUs capazes de DirectX 9 e, ainda mais difundidas, placas gráficas capazes de computação arbitrária ao invés das de funções fixas, comuns no fim da década anterior.
Em um parênteses, para os não iniciados, pense em GPUs e APIs de “função fixa” como tendo uma interface bem limitada, que te possibilita clicar em uns botões e girar algumas alavancas, mas que tomam responsabilidade e controle por realizar a maioria dos estágios da pipeline de renderização (você não gosta do Phong shader? Problema seu). Com o avanço das GPUs, este modelo deu lugar ao modelo de shaders programáveis, possibilitando que programadores tivessem muito mais controle e possibilidades com o que iriam fazer na pipeline.
Chegando aos dias atuais, percebendo o potencial em tarefas computacionais específicas, como as com grande quantidades de matrizes, múltiplas APIs foram criadas não para gráficos, mas para computação em GPUs. A mais conhecida é a CUDA da NVidia, mas também há o ROCm da AMD e a OpenCL, padronizada pela Khronos Group (mesmo pessoal que acabou herdando o OpenGL). Ainda há o Vulkan, que mesmo tendo sido originalmente concebida para gráficos, é capaz de realizar cargas computacionais gerais.
Todos esses avanços estão dando frutos não apenas na qualidade gráfica de jogos e aplicações, mas também na atual aplicação de LLMs, já que redes neurais profundas são modeladas como grandes sistemas lineares.
Entretanto, mesmo havendo tais opções modernas para programação gráfica, o estado atual é sofrível: APIs com paradigmas próprios; capacidades heterogêneas em hardware; certas funcionalidades apenas possíveis em sistemas operacionais proprietários; cisão entre a Apple e o resto do mercado com seus novos chips ARM e mais uma infinidade de problemas.
Então, todo e qualquer desenvolvedor que queira lançar aplicações gráficas precisam recorrer a abstrações, tornando seu programa agnóstico, mas desperdiçando performance, ou realizando a tarefa hercúlea de abstrair suas necessidades gráficas e escrever backends para cada API alvo, ou pior, para cada API alvo e possíveis funções do hardware subjacente.
Tenha em mente também que, para cada API gráfica, há uma linguagem de shading própria, assim como para cada engine de videogames, já que há certos intermediários no processo. Por isso, é comum programadores gráficos que trabalham diretamente na indústria “casarem” com uma engine ou uma determinada API, a fim de minimizar o ônus mental.

Com quem você quer se casar?
E como seria essa tal programação gráfica funcional?
Dado que precisamos separar estado e pensar, principalmente, em valores, podemos pensar nos primitivos computacionais: os vértices, os fragmentos e os pixels.
Por exemplo, um modelo nada mais é do que um combinado de vértices. Um shader instruiria uma série de operações a ocorrerem em cada vértice, e então, passaria como saída para tratar os fragmentos e assim por diante.
Entretanto, chegamos à mesma questão de como os programas gráficos já são produzidos. A ideia principal seria a remoção de boilerplate relacionada à administração de estado, assim como as estruturas de dados necessárias para gerenciar os buffers típicos das APIs atuais.
Uma inspiração razoável seriam as linguagens baseadas em nós, como os disponíveis no Blender. O mesmo se aplica para transformações geométricas. Isso se dá pelas linguagens funcionais conseguirem ser transformadas em grafos de dependências funcionais facilmente. Então, é possível, em tempo de compilação, executar uma série de otimizações e paralelização dos programas diretamente. Um bom exercício mental seria pensar nessas linguagens baseadas em nós como sendo o que o Scratch é para o JS ou o C, saca?

Shader Nodes no Blender
Isso poderia tornar o modelo mental da programação gráfica mais simples e contido, além de facilitar a visualização de como os dados fluem através da pipeline, e por sua vez, otimizar chamadas de desenhos na tela, de transformações e transferência de memória. Se for possível, em tempo de compilação, ter uma melhor chance de otimizar as chamadas à transferências entre memória principal e memória gráfica, e em tempo de execução, paralelizar tarefas com mais ergonomia. Com isso, já é possível justificar o estudo de uma API gráfica funcional.
Basicamente, tudo volta à noção do que um “encadeamento de operações” significa na programação funcional e na computação gráfica. Esperamos que a semelhança entre ambos tenha ficado clara e suas vantagens óbvias (pense nunca mais ter que ficar definindo tamanhos de buffers, ou ficar caçando bugs por você ter inserido, sem querer, a destruição de um buffer, gerando um use after free).
Problemas que isso resolveria
Como dito anteriormente, certas limitações atuais como controle das operações de entrada e saída são essenciais para a boa performance em computação heterogênea. Outra qualidade são as garantias providas pelas linguagens funcionais poderem ser exploradas para otimizações agressivas em cima de mudanças das arquiteturas subjacentes.
Temos também, como já citado, a questão do paralelismo, que se resolve um tanto melhor na PF. Condições de corrida não existem se não existir estado compartilhado, e estado compartilhado não existe se não existir estado e mutabilidade.
Além disso, talvez, e bota ênfase no talvez, APIs deste tipo poderiam atrair um pouco mais de atenção e talentos à CG, pois as portas estariam abertas para a pequena porém leal comunidade de programadores funcionais.
Problemas que isso também causaria
Neste maravilhoso artigo do John Carmack, ele explica que apesar da facilidade de manter um paralelismo, dentro de uma thread em específico provavelmente observaríamos uma perda de performance, pois ao evitar a mutação de um bloco de memória, as linguagens funcionais tendem a duplicar estes blocos; alocar mais memória a cada chamada de função. Ele também diz que linguagens funcionais modernas conseguem otimizar/contornar isso de alguma forma, mas provavelmente o custo ainda não é nulo, então seria necessário investigar se o paralelismo grátis compensa esse custo.
Uma possível mitigação seria, ao compilar um determinado programa, seu compilador analisar o tamanho dos buffers (pense nas funções como sendo nós de grafos, com os dados entrando de um lado e saindo do outro). E por termos garantias de imutabilidade, o compilador poderia otimizar espaço. Por exemplo, ao ser constatada o uso único de um conjunto de vértices, mas que sofre uma série de transformações, o tamanho exato poderia ser calculado (ou, pelo menos, um tamanho satisfatório), e as operações ocorrerem in place. Mas, se os dados forem utilizados por dois caminhos diferentes (e que geram duas saídas diferentes), uma cópia deverá ser preservada, mas você terá garantia de que será o número mínimo de cópias.
Já o principal problema em potencial da criação de uma grande nova API funcional seria tornar a situação atual do cenário de CG ainda pior, com mais uma API competindo com as demais: é o clássico XKCD 927.

XKCD 927
Se levarmos a proposta muito a sério, também teria toda a dificuldade de criação de infraestrutura, implementação de potenciais mudanças de hardware nos projetos de GPUs, necessidade de rever as linguagens de shaders e seus compiladores, os problemas relacionados a realizar as otimizações prometidas, e tudo isso pensando em tornar o resultado final melhor do que o que há hoje. Como não há garantias (pelo menos da nossa parte, somos bem estúpidos) de que nada disso iria funcionar, o que nos resta é explorar ou criar bibliotecas gráficas open source para linguagens funcionais — pensa num Raylib para Haskell que irado seria… ELE JÁ EXISTE!!! Mas parece mal documentado e meio abandonado, então sei lá.
Explorações futuras e exemplos que poderíamos ter
Dado o encontro ao acaso com a biblioteca de Haskell que opera sobre a API Vulkan, sugerimos que explore um pouco o repositório. Mesmo que ela ainda utilize a linguagem de shading HLSL para produzir, bem, shaders, acreditamos que o exemplo do triângulo dinâmico já é um bom começo.
Mesmo que um resultado semelhante possa ser alcançado com outras bibliotecas wrappers para linguagens procedurais, a possibilidade de conversão das funções em um grafo direcional acíclico, cujas otimizações podem ser feitas, novamente, ao capturar as dependências de dados e realizar otimização de chamadas de transferência de dados já é de grande interesse.
Fica ainda um projeto interessante de aliar à ideia: FIR, que nada mais é que uma versão de Haskell cujo compilador produz a representação intermediária utilizada por parte significativa da indústria hoje, o SPIR-V. Ou seja, uma linguagem de shaders funcional, podendo ser usada como alternativa ao GLSL ou HLSL. O que nos entristece é que o projeto está sendo mantido a conta-gotas, mas é compreensível o ritmo por se tratar de um hobby.
Ainda assim, há um imenso espaço a ser explorado nessa área, mesmo que não haja adoção inicial por gigantes da indústria.
Conclusão
Em seu famoso artigo “No Graphics API”, Sebastian Aaltonen fala sobre todos os problemas que temos no ecossistema de APIs gráficas e fornecedores de GPUs e, por fim, propõe um uma quebra geral de retrocompatibilidade na indústria para a próxima geração de APIs. A ideia é que quebremos as correntes que nos mantém fazendo coisas atrasadas e que comprometem a experiência de desenvolvedores (na visão do Sebastian um dos principais pontos é abraçar o modelo “bindless”). No mundo capetalista em que vivemos, dificilmente algo assim acontecerá. Contudo, somando nessa expectativa dele, depositamos aqui nossa esperança de que a próxima geração de APIs e bibliotecas também seja criada tendo em vista uma maior compatibilidade com linguagens funcionais.
Obrigado pela leitura!
메타데이터
- post_id
- 986b258b4dba
- slug
- desbravando-a-interseção-entre-computação-gráfica-e-programação-funcional-986b258b4dba
- url
- https://medium.com/@grupoconway.si/desbravando-a-interse%C3%A7%C3%A3o-entre-computa%C3%A7%C3%A3o-gr%C3%A1fica-e-programa%C3%A7%C3%A3o-funcional-986b258b4dba
- canonical_url
- https://medium.com/@grupoconway.si/desbravando-a-interse%C3%A7%C3%A3o-entre-computa%C3%A7%C3%A3o-gr%C3%A1fica-e-programa%C3%A7%C3%A3o-funcional-986b258b4dba
- author_url
- https://medium.com/@grupoconway.si
- status
- ok
- fetched_at
- 2026-07-11 04:07:45